Reguły z góry vs reguły z danych: dwa sposoby pisania programu
🎯 Po co Ci to?
To najważniejsza jednostka w pierwszej części książki. Cała różnica między informatyką, którą znasz ze szkoły, a sztuczną inteligencją, o której czytasz w mediach, mieści się w jednym odwróceniu: kto wymyśla przepis — człowiek czy maszyna. Kiedy to zobaczysz, zrozumiesz, dlaczego mówimy „trenowanie", a nie „programowanie" modelu, dlaczego dane stały się cenniejsze od kodu i dlaczego nikt — łącznie z twórcami — nie potrafi w pełni wyjaśnić, dlaczego model odpowiedział tak, a nie inaczej.
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- opisać klasyczne podejście do programowania i podejście oparte na uczeniu na tym samym przykładzie;
- wyjaśnić, co znaczy, że programistka „tworzy środowisko", w którym komputer sam znajduje przepis;
- wskazać, gdzie w każdym z podejść leży główna trudność;
- uzasadnić, dlaczego o AI mówimy „trenowanie", choć wciąż jest to program komputerowy.
🔁 Przypomnij sobie
Z Jednostki 2.3: algorytm to przepis, a dla rozpoznania kota na zdjęciu przepisu nie umiemy podać, bo nasza wiedza jest niejawna. Z Jednostki 2.4: dane trzeba zamienić na liczby, a wybór reprezentacji jest decyzją.
📘 Wyjaśnienie
Powstaje pytanie: skoro programowanie polega na wydawaniu komputerowi przez programistę lub programistkę instrukcji „zrób to, a potem tamto", to czy w ogóle można tu mówić o jakiejś inteligencji w komputerze? Czy komputer może „wymyślić" cokolwiek, czy też zawsze będzie ograniczony do wykonywania krok po kroku operacji, które my, ludzie, mu zlecimy?
Aby odpowiedzieć na te pytania, musimy zagłębić się nieco bardziej w sam proces programowania i zrozumieć, czym różni się klasyczne programowanie od programowania sztucznej inteligencji. Najlepiej zrobić to na przykładzie.
Przykład: program, który streszcza artykuł
Przyjmijmy, że naszym zadaniem jest napisanie programu komputerowego, który dla zadanego tekstu, na przykład artykułu prasowego (2–3 strony), będzie tworzył jego streszczenie (powiedzmy, maksymalnie 10 zdań).
Klasyczne podejście do tego problemu polega na tym, że programistka najpierw sama musi wymyślić, jak taki problem rozwiązać — na przykład: wytnij 3 pierwsze zdania ze wstępu artykułu i 2 ostatnie z zakończenia. Następnie programistka zapisuje krok po kroku swój pomysł rozwiązania problemu w języku programowania, a komputer go wykonuje.
Zauważ, jaki jest efekt: program zadziała zawsze tak samo i będzie dokładnie tak dobry, jak dobry był pomysł programistki. Dla wielu artykułów „pierwsze trzy i ostatnie dwa zdania" da wynik zaskakująco sensowny. Dla wywiadu, reportażu albo tekstu z puentą w środku — kompletnie bezużyteczny. Żeby go poprawić, trzeba wymyślić lepszą regułę. Potem następną, na kolejny typ tekstu. I tak dalej.
Programowanie sztucznej inteligencji odwraca ten proces. Programistka nie komunikuje komputerowi przepisu, czyli algorytmu, jak krok po kroku problem rozwiązać, ale tworzy w samym komputerze środowisko — to znaczy przestrzeń, w której komputer na podstawie wielu przykładów artykułów prasowych i ich streszczeń sam taki przepis wymyśli.
Przestrzenią, gdzie komputer samodzielnie szuka rozwiązania problemu, są najczęściej sztuczne sieci neuronowe. Programistka najpierw programuje, jak taka sieć ma wyglądać — to znaczy ile ma mieć neuronów, jaką ma mieć architekturę, czyli jak bardzo ma być złożona. Następnie określa długość procesu uczenia; w praktyce określa, ile razy komputer ma „studiować" zgromadzone wcześniej przykłady artykułów i ich streszczeń. Choć może brzmieć to dość tajemniczo, nie jest to bardzo skomplikowane — przekonasz się o tym w Części III.
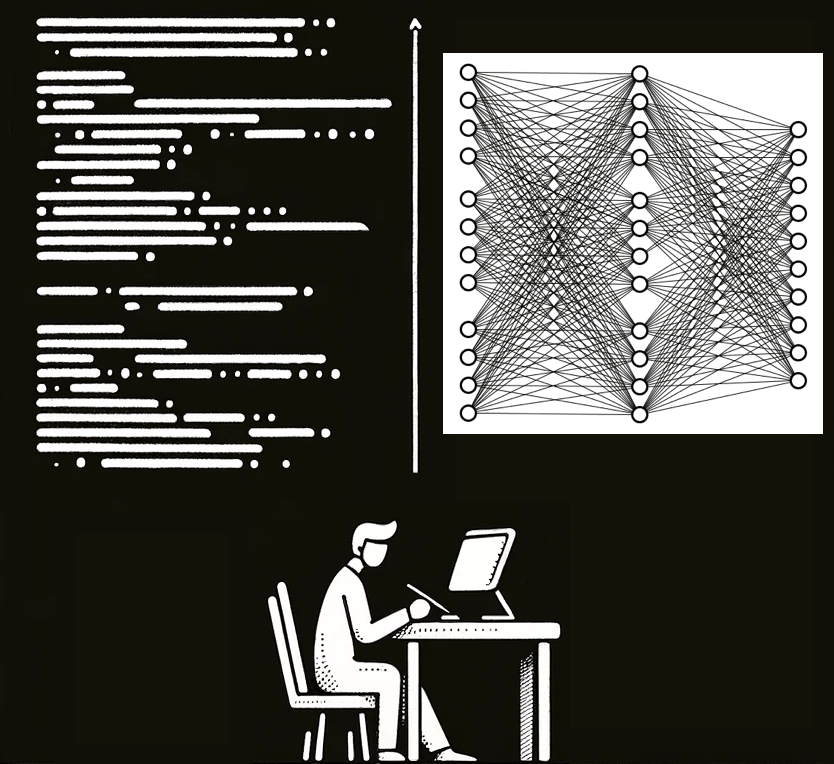
Z uwagi na to inne podejście do programowania sztucznej inteligencji mówi się raczej o trenowaniu sztucznej inteligencji niż o jej programowaniu. Nie zmienia to jednak faktu, że nadal jest to program komputerowy.
📐 DEFINICJA — trenowanie sztucznej inteligencji: tworzenie w komputerze środowiska (najczęściej sztucznych sieci neuronowych), w którym komputer na podstawie wielu przykładów, nazywanych zbiorem treningowym, sam wypracowuje rozwiązanie zadanego problemu.
Po ludzku: nie dajemy przepisu, dajemy przykłady i miejsce do nauki. Czym to NIE jest: trenowanie to nie „wgrywanie wiedzy" ani nie uczenie się w ludzkim sensie (ze zrozumieniem, w kontakcie ze światem). To dopasowywanie parametrów tak, by na przykładach wychodziło jak najmniej błędów.
Gdzie leży trudność — i dlaczego to zmienia zawód programisty
Zauważmy jeszcze, że główną trudnością przy klasycznym programowaniu byłoby wymyślenie przez programistkę, jak utworzyć streszczenia z artykułów prasowych, podczas gdy przy trenowaniu sztucznej inteligencji głównym problemem jest:
- stworzenie pokaźnego materiału do uczenia komputera, nazwanego zbiorem treningowym, złożonego z artykułów prasowych i ich gotowych streszczeń;
- dobranie odpowiedniej architektury sieci neuronowej oraz zdefiniowanie długości procesu uczenia.
Trudność nie zniknęła — przesunęła się. Z pytania „jak to zrobić?" na pytania „skąd wziąć dobre przykłady?" i „jak zbudować środowisko, żeby nauka się udała?". Dlatego w projektach AI tak wiele czasu zajmuje praca z danymi (pamiętasz z Jednostki 2.4: 50–80% czasu projektu), a nie pisanie kodu.
💭 Pomyśl: Klasyczny program streszczający można w całości przeczytać i wskazać linijkę odpowiedzialną za każdą decyzję. Co odpowiada „linijce z decyzją" w wytrenowanej sieci neuronowej?
Sprawdź odpowiedź
Nic tak konkretnego. Decyzja jest rozproszona w milionach (dziś: miliardach) liczb — wag połączeń między neuronami. Żadna pojedyncza waga nie odpowiada za „wybór trzeciego zdania"; efekt jest wypadkową wszystkich naraz.
To źródło zjawiska nazywanego czarną skrzynką: potrafimy sprawdzić, co model odpowiedział i zmierzyć, jak często się myli, ale nie umiemy wskazać w nim reguły, na jaką się powołał — bo taka reguła nie istnieje w formie, którą da się przeczytać. Wrócimy do tego przy 📐 wagach (Dział 10), przy uczeniu (Dział 11) i przy prawie, które wymaga wyjaśnialnych decyzji (Jednostka 20.3).
Trzeci sposób, o którym warto wiedzieć od razu
Ta książka będzie mówić o dwóch drogach, ale uczciwość każe od razu dodać: dziś większość realnych systemów to hybrydy. Model rozpoznaje treść, a klasyczny kod pilnuje reguł, których nie wolno naruszyć. Wyszukiwarka najpierw znajduje dokumenty klasycznym algorytmem, potem model formułuje odpowiedź (Jednostka 18.2). Kalkulator w narzędziach ChatGPT to zwykły, deterministyczny kod, bo model językowy jest w rachunkach zawodny. Dwie nogi AI z Jednostki 1.3 nie tyle rywalizują, ile coraz częściej chodzą razem — do czego wrócimy w Jednostce 22.1.
⚠️ Uwaga, pułapka
Bardzo łatwo przeczytać „komputer sam wymyśla przepis" jako „komputer jest twórczy i niezależny". Otóż nie: komputer szuka przepisu wyłącznie w przestrzeni, którą wyznaczył człowiek (architektura sieci), wyłącznie na podstawie przykładów, które dał człowiek (zbiór treningowy), i wyłącznie w kierunku, który wskazał człowiek (co uznajemy za błąd). Zmieniło się to, że człowiek nie musi znać rozwiązania — nie to, że przestał wyznaczać ramy. Jeśli w danych treningowych są ludzkie uprzedzenia, model wypracuje przepis, który je powtarza (Jednostka 20.2). Maszyna nie wymyśla „z niczego"; wyciska wzorce z tego, co dostała.
📐 Definicje tej lekcji
- Programowanie klasyczne — człowiek wymyśla algorytm i zapisuje go krok po kroku; komputer wykonuje.
- Trenowanie sztucznej inteligencji — człowiek buduje środowisko (sieć) i dostarcza przykłady; komputer sam wypracowuje rozwiązanie.
- Zbiór treningowy — zgromadzone przykłady (wejścia wraz z oczekiwanymi wynikami), na których uczy się model.
- Architektura sieci neuronowej — struktura środowiska nauki: liczba neuronów, liczba i układ warstw, sposób połączeń.
- Czarna skrzynka — cecha modelu, którego decyzji nie da się odczytać jako jawnej reguły, bo jest rozproszona w wielu parametrach.
📌 Najważniejsze w pigułce
- Klasycznie: człowiek zna przepis i go zapisuje. W AI: człowiek nie zna przepisu, więc buduje środowisko i daje przykłady.
- Środowiskiem jest najczęściej sztuczna sieć neuronowa; człowiek ustala jej architekturę i długość uczenia.
- Trudność przesuwa się z „jak to zrobić" na „skąd dobre dane" i „jaka architektura".
- Dlatego mówimy trenowanie, nie programowanie — choć rezultatem wciąż jest program komputerowy.
- Wytrenowany model jest czarną skrzynką: nie ma w nim linijki z regułą, jest rozkład liczb.
- „Sam wymyśla" nie znaczy „niezależnie" — ramy, dane i kryterium błędu wyznacza człowiek.
🎒 Zadania
Zadanie 3.2.1. Dla zadania „rozpoznaj, czy e-mail jest spamem" opisz oba podejścia: (a) klasyczne — podaj trzy konkretne reguły, jakie napisałbyś ręcznie, i wskaż, jak nadawca spamu je obejdzie; (b) uczące się — opisz, jak musiałby wyglądać zbiór treningowy.
Pokaż rozwiązanie
(a) Reguły: zawiera słowo „wygrałeś"; ma więcej niż 5 wykrzykników; nadawca nie jest w książce adresowej. Obejście: pisownia „w y g r a ł e ś" albo „WYGRAŁΕŚ" z grecką literą Ε, jeden wykrzyknik, podszycie się pod znanego nadawcę. Klasyczna reguła jest jawna, więc łatwa do obejścia — i każde obejście wymaga dopisania nowej reguły. To wyścig, w którym obrońca zawsze jest krok z tyłu.
(b) Zbiór treningowy: kilkadziesiąt tysięcy e-maili, każdy z etykietą „spam" / „nie spam", najlepiej pochodzących z realnego ruchu i regularnie odświeżanych (spam zmienia się w czasie — to zjawisko nazywa się dryfem danych). Model sam wychwyci wzorce, w tym takie, których nikt by nie wypisał. Cena: nie wiemy, na co dokładnie zwraca uwagę, i model odziedziczy błędy z etykiet.
Zadanie 3.2.2. Wyjaśnij, dlaczego zdanie „w klasycznym programowaniu trudność jest w kodzie, a w AI trudności nie ma" jest fałszywe. Wskaż dwie trudności specyficzne dla podejścia uczącego się.
Sprawdź odpowiedź
Trudność nie znika, a przesuwa się. Dwie specyficzne: (1) dane — trzeba zebrać dużo przykładów, poprawnie opisanych (etykietowanych), reprezentatywnych dla przypadków, w jakich model będzie działać; złe dane dają zły model niezależnie od jakości kodu; (2) środowisko i przebieg uczenia — trzeba dobrać architekturę i parametry treningu, a proces bywa kapryśny (przeuczenie, brak zbieżności — Jednostki 9.3 i 11.5). Dochodzi trzecia, jakościowo nowa: brak wglądu w to, czego model się nauczył.
Zadanie 3.2.3. Podaj przykład zadania, w którym podejście klasyczne jest wyraźnie lepsze niż uczące się, i uzasadnij dlaczego. (To pytanie rozwiniemy w Jednostce 3.5.)
Pokaż rozwiązanie
Przykłady: obliczenie podatku według ustawy; sprawdzenie sumy kontrolnej numeru PESEL; sterowanie sygnalizacją świetlną na skrzyżowaniu; przelew bankowy.
Uzasadnienie: reguła jest znana, jawna i musi być spełniona dokładnie, a błąd jest nieakceptowalny. Model uczący się dawałby wynik „prawie zawsze poprawny" — a w podatkach, medycynie dawkowania i finansach „prawie" jest wadą, nie zaletą. Dodatkowo klasyczny kod da się zaudytować i wyjaśnić przed sądem, model — znacznie trudniej.
🔍 Sprawdź, czy umiesz
- [ ] Opisać oba podejścia na tym samym przykładzie (streszczanie, spam).
- [ ] Wyjaśnić, co znaczy „tworzenie środowiska" i czym jest zbiór treningowy.
- [ ] Wskazać, gdzie leży główna trudność w każdym z podejść.
- [ ] Wyjaśnić, dlaczego mówimy „trenowanie" i dlaczego to wciąż program.
- [ ] Wyjaśnić, czym jest czarna skrzynka i skąd się bierze.