Dane, cechy, etykiety: z czego właściwie uczy się model
🎯 Po co Ci to?
„Sztuczna inteligencja potrzebuje danych" — to zdanie słyszałeś sto razy i nic z niego nie wynika. W tej jednostce zamienimy je na coś konkretnego: zobaczysz, w jakiej dokładnie postaci dane muszą być podane maszynie, kto i za jaką cenę dopisuje do nich odpowiedzi, i dlaczego zdanie „model jest uprzedzony" prawie nigdy nie znaczy „model jest złośliwy", a prawie zawsze — „dane były jednostronne". To jednostka, w której uczenie maszynowe przestaje być hasłem, a staje się listą zakupów.
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- wymienić cztery rzeczy, bez których żadne uczenie maszynowe nie jest możliwe;
- rozróżnić przykład, cechę i etykietę oraz wskazać je w konkretnym zbiorze danych;
- policzyć, ile cech ma obrazek o zadanym rozmiarze, i wyjaśnić, czym jest wektor cech;
- wyjaśnić, skąd biorą się etykiety i dlaczego etykietowanie jest najdroższym elementem całego procesu;
- rozpoznać, kiedy zbiór danych jest niereprezentatywny, i przewidzieć skutki tego dla modelu.
🔁 Przypomnij sobie
Z Jednostki 2.4 wiesz już rzecz, na której stoi cała ta jednostka: dla komputera wszystko jest liczbą. Obrazek to siatka pikseli, z których każdy ma wartość jasności; tekst to ciąg kodów znaków; dźwięk to ciąg próbek amplitudy. Z Jednostki 9.1 pamiętasz drugie kluczowe słowo: etykieta — dopisana do przykładu poprawna odpowiedź. Teraz połączymy jedno z drugim.
📘 Wyjaśnienie
Cztery rzeczy, bez których nie ma uczenia
Żeby komputer mógł nauczyć się wykonywać konkretne zadanie, muszą być spełnione cztery warunki. Wyjaśnijmy je na klasycznym problemie: rozpoznawanie ręcznie pisanych cyfr od 0 do 9.
- Dane treningowe. Zbiór obrazków przedstawiających cyfry. Zazwyczaj potrzebujemy tysięcy obrazków każdej cyfry, żeby maszyna zobaczyła różnorodność form i styli pisania. Każdy obrazek musi być opisany — czyli mieć przypisaną odpowiednią cyfrę od 0 do 9. Te opisy nazywamy etykietami (ang. label).
- Środowisko uczenia się, czyli model — najczęściej (choć nie zawsze) sztuczna sieć neuronowa. To struktura, w której coś może się zmieniać, żeby zapamiętać wzorzec z danych. Sieciami zajmiemy się w Dziale 10.
- Metoda oceny. Musimy umieć powiedzieć, jak bardzo model się myli — inaczej nie ma jak stwierdzić, czy się poprawia. To temat Jednostek 9.3 i 9.4, a matematycznie: funkcja straty z Jednostki 11.1.
- Metoda zmiany. Musimy umieć poprawić ustawienia modelu, gdy działa błędnie. To Dział 11 — spadek gradientu i propagacja wsteczna.
Zauważ, jak mało tu miejsca zajmuje „genialny algorytm", a jak dużo — przygotowanie danych. W realnych projektach to zwykle 60–80% pracy zespołu.
📐 DEFINICJA — dane treningowe: zbiór przykładów, na których model uczy się wykonywać zadanie; w uczeniu nadzorowanym każdy przykład składa się z danych wejściowych i dołączonej do nich poprawnej odpowiedzi (etykiety).
Po ludzku: zestaw zadań z kluczem odpowiedzi, na którym model ćwiczy. Czym to NIE jest: to nie „baza wiedzy", z której model potem odczytuje odpowiedzi. Po zakończeniu treningu dane treningowe nie są modelowi potrzebne — został z nich tylko zestaw liczb (wag).
Dla naszego przykładu z cyframi nie musimy nawet zbierać danych sami: istnieje publiczny zbiór MNIST, zawierający 70 000 ręcznie pisanych cyfr — obrazki 28 × 28 pikseli w skali szarości, każdy z etykietą. To najczęściej używany zbiór treningowy w historii nauczania uczenia maszynowego.
Przykład, cecha, etykieta
Trzy słowa, które trzeba rozróżniać precyzyjnie, bo mieszanie ich prowadzi do nieporozumień.
Przykład (nazywany też próbką albo obserwacją) to jeden element zbioru danych: jeden obrazek, jeden e-mail, jeden pacjent, jedno mieszkanie.
Cecha (ang. feature) to jedna, konkretna liczba opisująca ten przykład. Przykład opisujemy zwykle wieloma cechami naraz — ich uporządkowany zestaw nazywamy wektorem cech.
Etykieta to poprawna odpowiedź dla tego przykładu — to, co model ma przewidzieć.
Zobaczmy to na dwóch bardzo różnych zbiorach. Najpierw dane tabelaryczne — mieszkania:
| Przykład | metraż [m²] | piętro | rok budowy | odległość od centrum [km] | cena [tys. zł] |
|---|---|---|---|---|---|
| mieszkanie 1 | 48 | 3 | 1998 | 4,2 | 410 |
| mieszkanie 2 | 62 | 1 | 2015 | 1,8 | 720 |
| mieszkanie 3 | 35 | 7 | 1974 | 6,5 | 265 |
Każdy wiersz to przykład. Cztery pierwsze kolumny to cechy. Ostatnia kolumna (pogrubiona) to etykieta — cena, którą model ma się nauczyć przewidywać.
A teraz obrazek z MNIST. Tu nikt nie wymyślał cech ręcznie: cechą jest po prostu jasność jednego piksela. Obrazek 28 × 28 pikseli to 28 · 28 = 784 cechy, każda z wartością od 0 (czarny) do 255 (biały). Etykieta to jedna liczba: cyfra widoczna na obrazku.
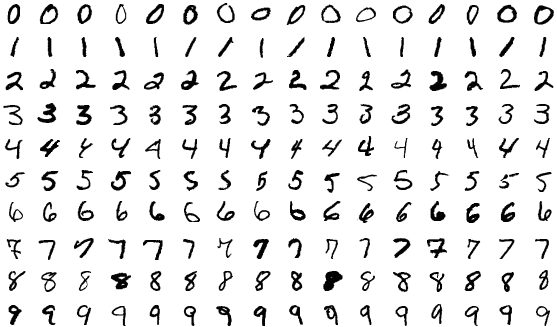
Zwróć uwagę, jak bardzo różnią się między sobą zapisy tej samej cyfry. Właśnie dlatego nikt nie próbuje napisać reguły „jak wygląda siódemka" — łatwiej zebrać kilkadziesiąt tysięcy przykładów i pozwolić modelowi znaleźć regułę samemu.
📐 DEFINICJA — cecha (feature) i wektor cech: cecha to pojedyncza, liczbowa właściwość opisująca przykład; wektor cech to uporządkowany zestaw wszystkich cech jednego przykładu, czyli sposób przedstawienia go maszynie.
Po ludzku: cecha to jedna kolumna w tabeli, wektor cech to jeden wiersz. Czym to NIE jest: cecha nie musi być czymś, co człowiek uznaje za sensowne. „Jasność piksela numer 431" nie znaczy nic dla nas i wszystko dla modelu.
💭 Pomyśl: Chcesz nauczyć model rozpoznawać, czy zdjęcie przedstawia kota, czy psa. Zdjęcia są kolorowe, o rozmiarze 224 × 224 piksele. Ile cech ma jeden przykład? Wskazówka: kolor każdego piksela zapisuje się trzema liczbami — natężeniem czerwieni, zieleni i błękitu.
Sprawdź odpowiedź
224 · 224 = 50 176 pikseli, a każdy piksel to trzy liczby (R, G, B), więc 50 176 · 3 = 150 528 cech. Jeden „zwykły" obrazek to zatem wektor złożony z ponad stu pięćdziesięciu tysięcy liczb — i takich wektorów model potrzebuje setek tysięcy, żeby się czegoś nauczyć. Stąd bierze się zapotrzebowanie na moc obliczeniową, o którym przeczytasz w Jednostce 13.1: nie z wyrafinowania obliczeń, ale z ich liczby.
Skąd biorą się etykiety
To pytanie brzmi banalnie, a jest jednym z najważniejszych w całej dziedzinie. Odpowiedź: etykiety pochodzą od ludzi. Ktoś musiał obejrzeć 70 000 obrazków MNIST i przy każdym zapisać, jaka to cyfra. Ktoś musiał przejrzeć miliony zdjęć ImageNet (Jednostka 13.2) i przypisać im kategorie. Ktoś musi oznaczyć zmiany skórne na zdjęciach dermatologicznych — i tu już nie wystarczy „ktoś", bo potrzebny jest lekarz, a często potwierdzenie badaniem histopatologicznym.
Dlatego etykietowanie jest zwykle najdroższym i najwolniejszym elementem projektu. Konsekwencje są bardzo praktyczne:
- Zadania, w których etykiety powstają „same z siebie", rozwijają się najszybciej. Klasyczny przykład: modele językowe (Dział 15) uczą się przewidywać następne słowo w tekście — etykietą jest po prostu kolejne słowo z tekstu, więc etykietowanie kosztuje zero. To jedna z głównych przyczyn eksplozji dużych modeli językowych.
- Tam, gdzie etykiety wymagają eksperta, dane są rzadkie i cenne — jak w medycynie (Jednostka 12.5).
- Gdy trzeba ocenić coś subtelnego (czy odpowiedź modelu jest pomocna? czy nie jest szkodliwa?), zatrudnia się ludzi do porównywania odpowiedzi. To dokładnie mechanizm, który zamienił surowy model GPT w ChatGPT — wrócisz do niego w Jednostkach 17.3 i 17.4.
Cechy podane przez człowieka a cechy odkryte przez model
W tabeli z mieszkaniami cechy wymyślił człowiek: metraż, piętro, rok budowy. Ten wybór jest częścią rozwiązania — i nazywa się inżynierią cech. Dobre cechy potrafią zdziałać więcej niż potężny model; jeśli zapomnisz o cechie „odległość od centrum", żaden algorytm jej sobie nie wymyśli.
Przy obrazkach ta droga się załamuje. Nikt nie potrafi wypisać listy cech opisujących „kociość". Historyczne systemy widzenia maszynowego próbowały: ręcznie programowano detektory krawędzi, narożników, tekstur. Przełom uczenia głębokiego (Dział 13) polegał na czymś innym: model sam buduje sobie coraz bardziej złożone cechy z surowych pikseli — pierwsza warstwa reaguje na krawędzie, dalsze na kształty, ostatnie na całe obiekty. To nazywamy uczeniem reprezentacji i zobaczysz je szczegółowo w Jednostkach 10.4 i 12.4.
💭 Pomyśl: Model do przewidywania cen mieszkań dostaje cechy: metraż, piętro, rok budowy, odległość od centrum. Ktoś proponuje dodać cechę „numer mieszkania" (np. 14, 27, 103). Czy to dobry pomysł? A cecha „liczba okien"?
Sprawdź odpowiedź
„Numer mieszkania" to cecha bez związku z ceną — jest przypadkowa. Model będzie próbował znaleźć w niej wzorzec, bo tego od niego wymagamy, i przy niewielkiej liczbie przykładów faktycznie znajdzie jakiś fałszywy („mieszkania z numerem powyżej 80 są tańsze") — po prostu dlatego, że w tych konkretnych danych tak wyszło. To jedna z dróg do przeuczenia (Jednostka 9.3). „Liczba okien" jest odwrotnie: sensownie związana z ceną (jasność, liczba pokoi), więc może pomóc — o ile da się ją wiarygodnie zmierzyć dla wszystkich przykładów. Zasada: cechy dodajemy wtedy, gdy mamy powód sądzić, że niosą informację, a nie „na wszelki wypadek".
Jakość danych: cztery typowe awarie
Niereprezentatywność. Jeśli zbiór zdjęć zmian skórnych zawiera prawie wyłącznie jasną karnację, model będzie działał znacznie gorzej na skórze ciemnej — nie z powodu złej woli, ale ponieważ takich przykładów po prostu nie widział. Ten sam mechanizm stoi za większością nagłówków o „uprzedzeniach sztucznej inteligencji" (wrócimy do nich w Jednostce 20.2).
Szum w etykietach. Ludzie się mylą i różnią między sobą. Część etykiet w każdym dużym zbiorze jest po prostu błędna, a model uczy się także tych błędów.
Braki i niespójności. Puste komórki, dwie różne jednostki w jednej kolumnie, daty w trzech formatach. Zanim model cokolwiek zobaczy, ktoś musi to uporządkować.
Nierównowaga klas. Jeśli w zbiorze jest 990 zdjęć zdrowej skóry i 10 zdjęć czerniaka, model może „nauczyć się" odpowiadać zawsze „zdrowa" i mieć 99% trafności — bezużyteczny, a na papierze świetny. To pułapka, którą rozbierzemy w Jednostce 9.4.
Wszystkie cztery mieszczą się w jednym zdaniu, które warto zapamiętać dosłownie: śmieci na wejściu, śmieci na wyjściu. Model nie jest mądrzejszy od danych, na których się uczył.
⚠️ Uwaga, pułapka
Krąży przekonanie, że „im więcej danych, tym lepszy model" — i że dane są obiektywne, bo to „po prostu fakty". Oba zdania są niebezpieczne. Dziesięć razy więcej danych tego samego, jednostronnego rodzaju nie naprawi modelu, a jedynie utrwali jego skrzywienie i doda pewności jego pomyłkom. A dane nigdy nie są neutralne: ktoś zdecydował, co mierzyć, kogo sfotografować, jakie kategorie dopuścić i jak nazwać przypadki wątpliwe. Każda z tych decyzji zostaje w modelu. Pytanie „skąd są te dane i kogo w nich brakuje?" jest ważniejsze niż pytanie „ile ich jest?".
🌍 Powiązania
Cztery składniki uczenia to szkielet całej Części III: dane poznałeś tutaj, model to Dział 10, ocena to Jednostki 9.3–9.4 i 11.1, zmiana to Dział 11. Sposób, w jaki tekst zamienia się na wektor cech, jest tak nieoczywisty, że dostał osobny dział (14). A pytanie o pochodzenie danych i cudzą pracę w nich zawartą wraca w Jednostkach 20.1 i 20.2.
📐 Definicje tej lekcji
- Dane treningowe — zbiór przykładów, na których model się uczy; w uczeniu nadzorowanym z dołączonymi etykietami.
- Przykład (próbka) — jeden element zbioru danych: obrazek, e-mail, pacjent, mieszkanie.
- Cecha (feature) — jedna liczbowa właściwość opisująca przykład.
- Wektor cech — uporządkowany zestaw wszystkich cech jednego przykładu.
- Etykieta (label) — poprawna odpowiedź dołączona do przykładu.
- Inżynieria cech — ręczne wymyślanie i wyliczanie cech przez człowieka.
- Uczenie reprezentacji — samodzielne budowanie cech przez model z surowych danych.
📌 Najważniejsze w pigułce
- Uczenie wymaga czterech rzeczy: danych, modelu, metody oceny i metody zmiany.
- Przykład opisujemy cechami; ich zestaw to wektor cech. Obrazek 28 × 28 to 784 cechy, kolorowy 224 × 224 — ponad 150 tysięcy.
- Etykiety pochodzą od ludzi i zwykle są najdroższym elementem projektu; zadania z „darmowymi" etykietami (przewidywanie następnego słowa) rozwijają się najszybciej.
- Cechy mogą być wymyślone przez człowieka (dane tabelaryczne) albo odkryte przez model (uczenie głębokie).
- Model nie jest mądrzejszy od swoich danych: niereprezentatywny zbiór daje skrzywiony model, a więcej takich samych danych tego nie naprawia.
🎒 Zadania
Zadanie 9.2.1. Sieć ma rozpoznawać cyfry z obrazków w skali szarości o rozmiarze 20 × 20 pikseli. (a) Ile cech ma jeden przykład? (b) Ile liczb trzeba wczytać, żeby podać sieci 5 000 przykładów treningowych? (c) Jak zmieni się odpowiedź (a), jeśli obrazki będą kolorowe?
Pokaż rozwiązanie
(a) 20 · 20 = 400 cech (po jednej wartości jasności na piksel). (b) 400 · 5 000 = 2 000 000 liczb — dwa miliony wartości dla całkiem niewielkiego zbioru małych obrazków. (c) Kolor zapisujemy trzema składowymi na piksel, więc 400 · 3 = 1200 cech. Przejście na kolor potraja rozmiar wejścia, choć obrazek dla człowieka „wygląda tak samo".
Zadanie 9.2.2. Szpital chce zbudować model przewidujący, czy pacjent zgłaszający się na izbę przyjęć będzie wymagał hospitalizacji. Wypisz: (a) co jest jednym przykładem, (b) trzy sensowne cechy, (c) etykietę, (d) skąd realnie weźmie się etykiety.
Pokaż rozwiązanie
(a) Jednym przykładem jest jedna wizyta pacjenta na izbie przyjęć (uwaga: nie „pacjent" — ten sam pacjent może zgłosić się wielokrotnie, a każda wizyta jest osobnym przypadkiem). (b) Przykładowe cechy: wiek, wartości podstawowych parametrów życiowych (tętno, ciśnienie, saturacja), wynik triage'u, liczba chorób przewlekłych, wyniki podstawowych badań krwi. (c) Etykieta: czy wizyta zakończyła się hospitalizacją (tak / nie) — zmienna dwuwartościowa, więc to zadanie klasyfikacji (Jednostka 9.5). (d) Etykiety są tu wyjątkowo tanie, bo powstają same: szpital i tak zapisuje w systemie, czy pacjent został przyjęty. To przykład zadania, w którym historia dokumentacji medycznej dostarcza gotowych odpowiedzi — nikt nie musi ich dopisywać ręcznie. Trzeba jednak uważać na cechy dostępne dopiero po decyzji o przyjęciu (np. „numer oddziału") — ich użycie to przeciek danych, o którym w następnej jednostce.
Zadanie 9.2.3. Firma zbiera zdjęcia do modelu rozpoznającego znaki drogowe. Wszystkie zdjęcia zrobiono w słoneczne dni, latem, w jednym mieście, tym samym aparatem. Wskaż co najmniej trzy sytuacje, w których model zawiedzie, i wyjaśnij, dlaczego dołożenie kolejnych 100 000 takich samych zdjęć nie pomoże.
Pokaż rozwiązanie
Model zawiedzie m.in.: (1) w deszczu, mgle i po zmroku — inne kontrasty i odblaski; (2) zimą, gdy znaki są częściowo zaśnieżone albo tło jest białe; (3) w innym mieście lub kraju, gdzie znaki mają inny wygląd, inne mocowanie albo są zasłonięte roślinnością; (4) po zmianie aparatu — inna optyka, ostrość i barwy niż te, do których model przywykł.
Dołożenie kolejnych 100 000 zdjęć tego samego rodzaju nie pomoże, bo problemem nie jest liczba przykładów, ale brak różnorodności: w danych po prostu nie ma informacji o tym, jak wygląda znak w deszczu czy w śniegu. Model może się z takich danych nauczyć wyłącznie tego, co w nich jest. Lekarstwem jest zmiana składu zbioru (inne pory dnia, roku, pogoda, miasta, urządzenia), a nie jego rozmiaru.
🔍 Sprawdź, czy umiesz
- [ ] Wymienić cztery warunki, bez których uczenie maszynowe nie jest możliwe.
- [ ] Wskazać przykład, cechę i etykietę w podanej tabeli danych.
- [ ] Policzyć liczbę cech dla obrazka o danym rozmiarze, w skali szarości i w kolorze.
- [ ] Wyjaśnić, dlaczego etykietowanie jest najdroższym elementem projektu i które zadania są od tego kosztu wolne.
- [ ] Rozpoznać niereprezentatywny zbiór danych i przewidzieć, jak zawiedzie wyuczony na nim model.