Warstwy i funkcje aktywacji
🎯 Po co Ci to?
W tej jednostce jest jedno rozstrzygnięcie, bez którego uczenie głębokie nie miałoby sensu — a które można wyłożyć w trzech linijkach algebry ze szkoły średniej. Zrozumiesz, dlaczego sieć bez funkcji aktywacji, choćby miała tysiąc warstw i miliard parametrów, potrafi dokładnie tyle samo, co jeden neuron. I dlaczego jedna prosta, wręcz banalna funkcja — „jeśli liczba jest ujemna, zamień ją na zero" — okazała się jednym z ważniejszych praktycznych przełomów w historii tej dziedziny.
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- opisać budowę sieci: warstwa wejściowa, ukryte, wyjściowa;
- policzyć liczbę parametrów prostej sieci gęsto połączonej;
- wykazać, że złożenie warstw liniowych bez aktywacji jest równoważne jednej warstwie;
- porównać funkcje aktywacji: progową, sigmoidalną, tanh i ReLU, i uzasadnić popularność ReLU;
- wyjaśnić rolę funkcji softmax na wyjściu sieci;
- powiedzieć, co dokładnie znaczy słowo „głębokie" w „uczeniu głębokim".
🔁 Przypomnij sobie
Z Jednostki 10.1: neuron liczy sumę ważoną i przepuszcza ją przez funkcję aktywacji. Z Jednostki 8.4: pojedynczy Perceptron nie potrafi policzyć XOR, bo umie rozdzielić dane tylko jedną prostą — a XOR-a żadna prosta nie rozdziela. Minsky i Papert wiedzieli, że wiele warstw by pomogło; nie było jednak wtedy metody ich uczenia (to wraca w Dziale 11).
📘 Wyjaśnienie
Jeden neuron nic nie zdziała — potrzebna jest sieć
Pojedynczy neuron rozstrzyga jedną prostą rzecz. Żeby rozwiązywać zadania w rodzaju rozpoznawania mowy czy pisma, neurony łączymy w sieć, układając je w warstwy:
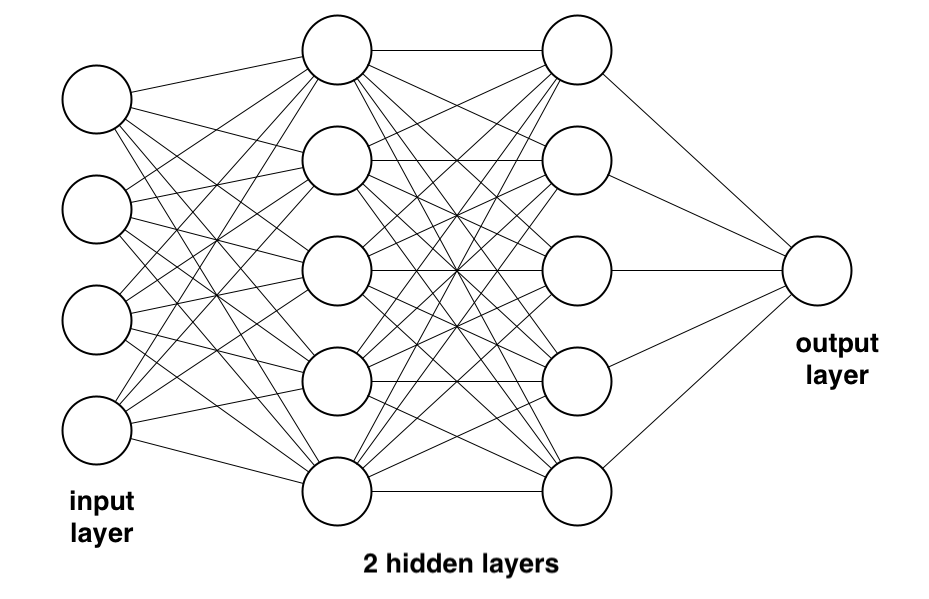
- Warstwa wejściowa przyjmuje liczby opisujące dane. Nie liczy nic — to po prostu miejsce, w którym dane wchodzą do sieci.
- Warstwy ukryte — dowolnie wiele warstw pomiędzy wejściem a wyjściem. Nazywamy je ukrytymi, bo ich wartości nie są ani danymi, ani odpowiedzią; nikt ich z zewnątrz nie widzi i nikt nie ustala z góry, co mają znaczyć.
- Warstwa wyjściowa podaje wynik: jedną liczbę (regresja) albo po jednej liczbie na każdą możliwą klasę (klasyfikacja).
W najczęstszym układzie — warstwie gęstej, zwanej też w pełni połączoną — każdy neuron warstwy jest połączony z każdym neuronem warstwy poprzedniej. Pomocna bywa tu metafora neuronów-ekspertów: eksperci z warstwy wejściowej przyjmują dane surowe i przekazują je wszystkim ekspertom pierwszej warstwy ukrytej. Ci ważą je po swojemu, przetwarzają i przekazują dalej — do ekspertów drugiej warstwy ukrytej. Ci robią to samo. Rezultat swoich „przemyśleń" ostatnia warstwa ukryta oddaje ekspertom z warstwy wyjściowej, którzy podejmują decyzję.
Metafora jest wygodna, ale trzymaj ją na krótkiej smyczy: żaden z tych „ekspertów" nie ma wiedzy ani intencji. To po prostu neuron, który po treningu reaguje mocniej na jeden układ wejść niż na inne. Do pytania, na co dokładnie reagują, wrócimy w Jednostce 10.4.
Ile jest parametrów
Policzmy, ile liczb trzeba dobrać w sieci o warstwach 784 → 16 → 16 → 10 (to niedługo będzie nasz przykład z cyframi).
Każdy neuron warstwy ukrytej ma tyle wag, ile jest neuronów w warstwie poprzedniej, plus jedno obciążenie:
- warstwa ukryta 1: 16 neuronów × (784 wag + 1) = 12 560
- warstwa ukryta 2: 16 neuronów × (16 wag + 1) = 272
- warstwa wyjściowa: 10 neuronów × (16 wag + 1) = 170
Razem 13 002 parametry — i to w sieci uznawanej dziś za zabawkową. Dla porównania: modele językowe, o których będzie Część IV, mają ich setki miliardów. Każdy z tych parametrów jest liczbą, którą trzeba dobrać w procesie uczenia; stąd zapotrzebowanie na dane i moc obliczeniową, o którym mówi Dział 13.
Sedno: dlaczego bez aktywacji warstwy się „zapadają"
Teraz najważniejsza rzecz w tym dziale. Wyobraź sobie sieć bez funkcji aktywacji — same sumy ważone. Weźmy dwie warstwy i jedno wejście, żeby dało się to policzyć na kartce.
Pierwsza warstwa liczy: h = w · s + b. Druga warstwa liczy: y = v · h + c.
Podstawmy pierwsze do drugiego:
y = v · (w · s + b) + c = (v · w) · s + (v · b + c)
Popatrz na wynik: to znowu jedna waga pomnożona przez wejście plus jedna liczba. Oznaczając W = v·w i B = v·b + c, mamy y = W · s + B — czyli dokładnie to, co potrafi jedna warstwa. Dwie warstwy nie dały nic nowego. I nie zależy to od liczby warstw: złożenie stu przekształceń liniowych jest przekształceniem liniowym. Sto warstw bez aktywacji to bardzo kosztowny sposób zapisania jednej.
To znaczy, że cała moc sieci głębokich bierze się z nieliniowości wciśniętej między warstwy. Funkcja aktywacji nie jest kosmetycznym dodatkiem „bo tak w mózgu" — jest jedynym powodem, dla którego głębokość ma sens. Zauważ też, że to zamyka wątek z Jednostki 8.4: XOR nie da się rozdzielić jedną prostą, a sieć bez aktywacji zawsze rysuje tylko prostą (albo, w wielu wymiarach, płaszczyznę). Z nieliniową aktywacją i jedną warstwą ukrytą — da się, i to bez trudu.
📐 DEFINICJA — funkcja aktywacji: nieliniowa funkcja przekształcająca sumę ważoną neuronu w jego wyjście.
Po ludzku: to ona decyduje, „jak mocno" neuron się odzywa — i to ona sprawia, że warstwy nie zapadają się w jedną. Czym to NIE jest: to nie próg „na końcu sieci" ani element dekoracyjny; nieliniowość musi być między warstwami, inaczej głębokość niczego nie daje.
Cztery funkcje aktywacji, które warto znać
Funkcja progowa (skokowa) — 1 gdy suma dodatnia, 0 w przeciwnym razie. Ta z Perceptronu i z Jednostki 10.1. Zaleta: prosta i zgodna z metaforą „impulsu". Wada, przez którą dziś się jej nie używa: jest skokowa, więc drobna zmiana wagi albo nic nie zmienia, albo zmienia wszystko naraz. Uczenie potrzebuje informacji „w którą stronę i jak mocno poprawić" — a próg jej nie daje (dlaczego dokładnie, zobaczysz w Jednostce 11.2).
Sigmoida — gładka litera S, ściskająca każdą liczbę do przedziału od 0 do 1. Wynik da się czytać jako „stopień pewności". Przez dekady standard. Wada: dla wejść bardzo dużych albo bardzo małych wykres jest niemal płaski, więc sygnał do poprawy wag prawie zanika — to zapowiedź problemu zanikającego gradientu z Jednostki 11.5.
Tangens hiperboliczny (tanh) — jak sigmoida, ale ściska do przedziału od −1 do 1, a więc symetrycznie wokół zera, co zwykle uczy się lepiej. Ma tę samą wadę płaskich ogonów.
ReLU (ang. rectified linear unit) — najprostsza z nich i dziś najczęstsza: jeśli liczba jest ujemna, zwróć zero; jeśli dodatnia, zwróć ją bez zmian.
 sigmoida            tanh                ReLU
     1 ┤   ╭────      1 ┤   ╭────           ┤      /
       │  ╱             │  ╱                │     /
   0,5 ┤ │            0 ┤─┼─                │    /
       │╱               │╱                  │   /
     0 ┼────         −1 ┤────             0 ┼──────
Dlaczego akurat ta zwyciężyła? Bo jest nieliniowa (załamanie w zerze wystarcza, by warstwy się nie zapadły), tania (jedno porównanie zamiast funkcji wykładniczej), a przede wszystkim nie ma płaskiego ogona po stronie dodatniej, więc sygnał do poprawy wag przechodzi przez wiele warstw bez wygasania. Praktyczne upowszechnienie ReLU około 2010–2012 roku było jednym z tych niepozornych kroków, które umożliwiły trenowanie sieci naprawdę głębokich (Dział 13).
Softmax: wyjście, które można czytać jako pewność
Na końcu sieci klasyfikującej mamy po jednym neuronie na każdą klasę, a ich surowe wyjścia to dowolne liczby (np. 2,3; −1,1; 5,7). Chcielibyśmy z nich zrobić coś czytelnego: zestaw liczb dodatnich sumujących się do 1, czyli rozkład pewności. Robi to funkcja softmax: podnosi każdą liczbę do potęgi (e do danej liczby, co czyni wszystkie wartości dodatnimi i wzmacnia różnice), a potem dzieli każdą przez sumę wszystkich.
Skutek praktyczny: największe surowe wyjście dostaje największą pewność, a całość sumuje się do 100%. Dzięki temu model mówi nie tylko „to siódemka", ale „siódemka z pewnością 0,93, dziewiątka 0,05, jedynka 0,01". Że ta liczba nie jest prawdopodobieństwem prawdy w potocznym sensie — o tym w następnej jednostce.
Co znaczy „głębokie" uczenie
Teraz da się powiedzieć wprost: „głębokie" to po prostu „o wielu warstwach ukrytych". Nie ma tu żadnego drugiego znaczenia — ani filozoficznego, ani odnoszącego się do „głębi rozumienia". Sieć z jedną warstwą ukrytą to sieć płytka; sieć z kilkudziesięcioma albo kilkuset — głęboka. Po co ta głębokość, skoro (jak dowiedziono matematycznie) już jedna warstwa ukryta o dostatecznej szerokości potrafi przybliżyć dowolną funkcję? Bo „potrafi w teorii" i „da się nauczyć w praktyce" to dwie różne rzeczy: głębokie sieci budują hierarchię pojęć, przez co uczą się skuteczniej i z mniejszej liczby parametrów niż jedna gigantyczna warstwa. Tej hierarchii przyjrzymy się w Jednostce 10.4.
💭 Pomyśl: Ktoś proponuje sieć o warstwach 100 → 50 → 50 → 1, w której jako funkcję aktywacji we wszystkich warstwach ukrytych ustawiono f(z) = 2z (podwojenie). Ile realnie wynosi zdolność tej sieci do wyrażania zależności? Co dokładnie jest tu nie tak?
Sprawdź odpowiedź
Ta sieć jest równoważna pojedynczej warstwie liniowej — czyli zwykłej regresji liniowej z Jednostki 9.5, tylko liczonej z ogromnym marnotrawstwem. Powód: f(z) = 2z jest funkcją liniową, a złożenie funkcji liniowych jest liniowe. Mnożenie przez 2 da się „wciągnąć" do wag następnej warstwy dokładnie tak, jak w rachunku pokazanym wyżej, więc wszystkie warstwy zapadają się w jedną.
To nie jest problem „za małej nieliniowości" — problemem jest brak jakiejkolwiek nieliniowości. Wystarczyłoby zastąpić f(z) = 2z choćby ReLU (czyli dodać jedno załamanie w zerze!), by sieć zaczęła wyrażać zależności, których żadna prosta nie opisuje. Stąd wniosek praktyczny: funkcja aktywacji musi być nieliniowa, ale wcale nie musi być skomplikowana.
⚠️ Uwaga, pułapka
Z tego, że głębokość jest źródłem mocy, wielu wyciąga wniosek: „dodam więcej warstw, będzie lepiej". Nie będzie — a bywa gorzej, z trzech różnych powodów. Po pierwsze więcej warstw to więcej parametrów, więc łatwiejsze przeuczenie (Jednostka 9.3), zwłaszcza przy małym zbiorze danych. Po drugie w bardzo głębokich sieciach sygnał do poprawy wag potrafi po drodze wygasnąć — to zanikający gradient (Jednostka 11.5), z powodu którego przez lata nie umiano trenować sieci głębszych niż kilka warstw. Po trzecie koszt: każda warstwa to czas obliczeń i zużycie energii, przy treningu i przy każdym późniejszym użyciu modelu. Architekturę sieci dobiera się do zadania i do ilości danych, a nie „na maksa".
📐 Definicje tej lekcji
- Warstwa wejściowa — miejsce wprowadzenia danych; nie wykonuje obliczeń.
- Warstwa ukryta — warstwa między wejściem a wyjściem; jej wartości nie są ani danymi, ani odpowiedzią.
- Warstwa wyjściowa — warstwa podająca wynik sieci.
- Warstwa gęsta (w pełni połączona) — każdy neuron połączony z każdym neuronem warstwy poprzedniej.
- Funkcja progowa — aktywacja skokowa: 0 albo 1.
- Sigmoida — gładka aktywacja ściskająca wynik do przedziału (0, 1).
- Tanh — aktywacja ściskająca wynik do przedziału (−1, 1).
- ReLU — aktywacja zerująca wartości ujemne, przepuszczająca dodatnie bez zmian.
- Softmax — przekształcenie wyjść warstwy końcowej w rozkład pewności sumujący się do 1.
- Uczenie głębokie — uczenie sieci o wielu warstwach ukrytych.
📌 Najważniejsze w pigułce
- Sieć to warstwy: wejściowa, dowolnie wiele ukrytych, wyjściowa. W warstwie gęstej każdy neuron łączy się z każdym z poprzedniej.
- Liczba parametrów rośnie szybko: sieć 784 → 16 → 16 → 10 ma już ponad 13 tysięcy liczb do dobrania.
- Bez funkcji aktywacji sto warstw jest równoważne jednej — złożenie przekształceń liniowych jest liniowe. To jedyny powód, dla którego głębokość ma sens.
- ReLU (zeruj ujemne) wygrała, bo jest nieliniowa, tania i nie wygasza sygnału uczącego.
- Softmax zamienia surowe wyjścia w liczby sumujące się do 1, czytelne jako pewność.
- „Głębokie" znaczy dokładnie „o wielu warstwach ukrytych" — nic więcej.
- Więcej warstw nie znaczy lepiej: grożą przeuczenie, zanikający gradient i koszt.
🎒 Zadania
Zadanie 10.2.1. Policz liczbę parametrów (wag i obciążeń) sieci gęstej o warstwach 100 → 64 → 32 → 5. Następnie oszacuj, ile parametrów miałaby sieć 100 → 1000 → 5 i porównaj oba wyniki. Który układ ma więcej parametrów, a który jest głębszy?
Pokaż rozwiązanie
Sieć 100 → 64 → 32 → 5:
- warstwa 1: 64 × (100 + 1) = 6464
- warstwa 2: 32 × (64 + 1) = 2080
- warstwa 3: 5 × (32 + 1) = 165
- razem: 8709
Sieć 100 → 1000 → 5:
- warstwa 1: 1000 × (100 + 1) = 101 000
- warstwa 2: 5 × (1000 + 1) = 5005
- razem: 106 005
Druga sieć ma ponad dwanaście razy więcej parametrów, a jest płytsza (jedna warstwa ukryta wobec dwóch). To dobra ilustracja różnicy między „szeroko" i „głęboko": szerokość kupuje się liczbą parametrów bardzo drogo, natomiast głębokość pozwala uzyskać złożone zależności taniej — pod warunkiem, że umiemy taką sieć wytrenować (Dział 11).
Zadanie 10.2.2. Wykaż rachunkiem, że sieć o dwóch warstwach z aktywacją tożsamościową f(z) = z jest równoważna jednej warstwie. Użyj jednego wejścia s, wag w i v oraz obciążeń b i c. Następnie wyjaśnij, dlaczego ten sam rachunek nie przechodzi, gdy aktywacją jest ReLU.
Pokaż rozwiązanie
Z aktywacją tożsamościową: h = w·s + b, y = v·h + c = v·(w·s + b) + c = (v·w)·s + (v·b + c). Podstawiając W = v·w oraz B = v·b + c, dostajemy y = W·s + B — czyli jedną warstwę.
Dla ReLU rachunek się załamuje w pierwszym kroku, bo h = max(0, w·s + b), a tego wyrażenia nie da się rozwinąć jako mnożenia i dodawania — max nie jest liniowe. Konkretnie: wynik zależy od znaku sumy w·s + b, więc dla części wejść neuron przekazuje sygnał, a dla części zwraca zero. To „zależy od znaku" jest właśnie nieliniowością: sieć może teraz zachowywać się inaczej w różnych obszarach przestrzeni wejść, a złożenie wielu takich załamań pozwala przybliżyć niemal dowolną zależność.
Zadanie 10.2.3. Warstwa wyjściowa sieci rozpoznającej trzy gatunki kwiatów dała surowe wyjścia: 2,0; 1,0; 0,0. Wyjaśnij słowami, co zrobi z nimi softmax, i wskaż (bez dokładnego liczenia), która klasa dostanie największą pewność oraz czy różnica między pierwszą i drugą klasą będzie po softmaksie mniejsza, czy większa niż różnica surowych wyjść.
Pokaż rozwiązanie
Softmax najpierw podnosi liczbę e do potęgi każdego wyjścia (2,0 → około 7,39; 1,0 → około 2,72; 0,0 → 1), przez co wszystkie wartości stają się dodatnie, a różnice między nimi zostają wzmocnione (funkcja wykładnicza rośnie coraz szybciej). Potem dzieli każdą z nich przez ich sumę (około 11,11), dzięki czemu wyniki sumują się do 1: w przybliżeniu 0,67; 0,24; 0,09.
Największą pewność dostanie pierwsza klasa (największe surowe wyjście — softmax nie zmienia kolejności). Różnica surowych wyjść między pierwszą i drugą klasą to 1,0, czyli połowa wartości pierwszego wyjścia; po softmaksie stosunek pewności to 0,67 do 0,24, czyli prawie trzykrotny. Softmax wyostrza różnice — i właśnie dlatego modele często brzmią bardzo pewnie nawet wtedy, gdy surowe wyjścia były do siebie zbliżone. To ważne przy czytaniu „pewności" modelu, o czym w Jednostce 10.3.
🔍 Sprawdź, czy umiesz
- [ ] Nazwać trzy rodzaje warstw i powiedzieć, co robi każda.
- [ ] Policzyć liczbę parametrów sieci gęstej z podanych rozmiarów warstw.
- [ ] Pokazać rachunkiem, że warstwy bez nieliniowości zapadają się w jedną.
- [ ] Wymienić cztery funkcje aktywacji i podać zaletę oraz wadę każdej.
- [ ] Uzasadnić, dlaczego ReLU wyparła sigmoidę w warstwach ukrytych.
- [ ] Wyjaśnić, co robi softmax i po co.
- [ ] Powiedzieć, co dokładnie znaczy „głębokie" w „uczeniu głębokim".