Sieć w akcji: przykład działania sieci już nauczonej
🎯 Po co Ci to?
Czas przepuścić przez sieć prawdziwe dane i policzyć, co się z nimi dzieje — krok po kroku, od pikseli do odpowiedzi. Weźmiemy klasyczny problem rozpoznawania odręcznie napisanych cyfr; to zadanie, na którym uczyły się całe pokolenia badaczy i na którym najłatwiej zobaczyć całą maszynerię naraz. Po tej jednostce będziesz umiał wskazać każdą liczbę w tym procesie i powiedzieć, skąd się wzięła. Dowiesz się też, jak czytać zdanie „model jest pewny na 99%" — i dlaczego to nie znaczy tego, co się wydaje.
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- opisać, jak obrazek zamienia się w wektor liczb wejściowych;
- przejść krok po kroku przez przepływ w przód (od wejścia do wyjścia);
- wyjaśnić, dlaczego warstwa wejściowa ma 784 neurony, a wyjściowa 10;
- odczytać wynik sieci jako rozkład pewności i wskazać, czego on nie mówi;
- oszacować, ile mnożeń wymaga jedna odpowiedź sieci.
🔁 Przypomnij sobie
Z Jednostki 2.4: obraz w komputerze to liczby — każdy piksel ma swoją wartość, a w obrazie w odcieniach szarości jest to jedna liczba od 0 (czarny) do 255 (biały). Z Jednostki 10.1: neuron mnoży wejścia przez wagi i sumuje. Z Jednostki 10.2: warstwy, ReLU, softmax. Wszystko, co potrzebne, już mamy — teraz to składamy.
📘 Wyjaśnienie
Zadanie: odręcznie napisane cyfry
Mamy obrazek 28 na 28 pikseli w odcieniach szarości, na którym ktoś napisał ręcznie cyfrę — powiedzmy siódemkę. Sieć ma odpowiedzieć, która to cyfra spośród dziesięciu (0–9). To zadanie klasyfikacji w sensie Jednostki 9.5, o dziesięciu klasach.
Podkreślmy raz jeszcze: sieć jest już nauczona. Wszystkie jej wagi mają ustalone wartości; nie zmieniają się w trakcie tego, co teraz opiszemy. To, co robimy, nazywa się przepływem w przód (ang. forward pass) i jest dokładnie tym, co dzieje się w każdym modelu przy każdym pytaniu — od klasyfikatora cyfr do modelu językowego odpowiadającego na Twój prompt.
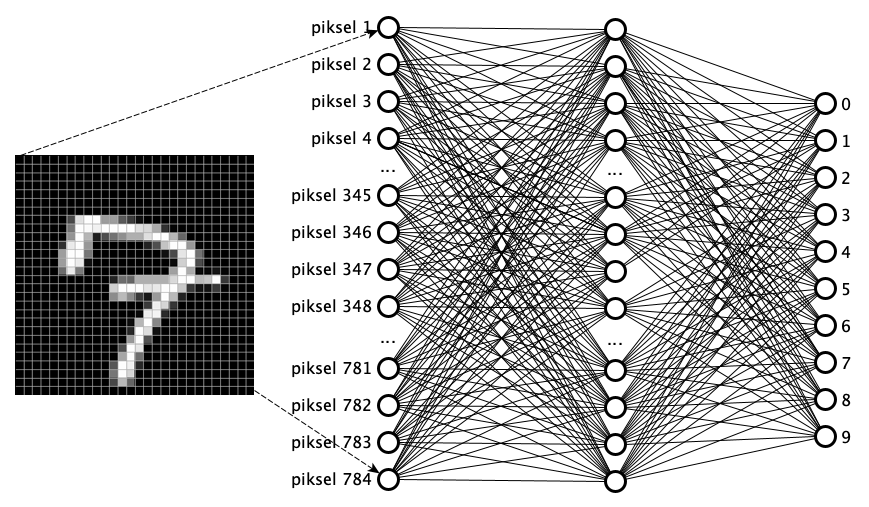
Miej tę rycinę pod okiem: przejdziemy ją teraz od lewej do prawej, krok po kroku.
Krok 1: obrazek staje się 784 liczbami
Obrazek 28 × 28 ma 28 · 28 = 784 piksele. Wartość każdego piksela to jedna liczba od 0 do 255. Ustawiamy je w jeden długi rząd (ta operacja nazywa się „spłaszczeniem") i dostajemy 784 liczby — po jednej dla każdego neuronu warstwy wejściowej. Każdy neuron wejściowy przyjmuje „impuls" w postaci jasności dokładnie jednego piksela.
W praktyce liczby te dzieli się jeszcze przez 255, żeby zamiast zakresu 0–255 mieć 0–1. To ta sama normalizacja, o której było w Jednostce 9.5: różne skale wejść utrudniają uczenie, więc sprowadzamy je do wspólnego zakresu.
 obrazek 28×28          spłaszczenie           warstwa wejściowa
 ┌───────────┐
 │ . . ███ . │   →   [0, 0, 0, 231, 255,  →   784 neurony
 │ . . . █ . │        18, 0, ... , 0]          (po jednym
 │ . . ██ .  │        └── 784 liczby ──┘        na piksel)
 │ . ██ . .  │
 └───────────┘
Zauważ, co przy tym tracimy: po spłaszczeniu sieć nie wie już, które piksele były obok siebie. Dla niej to po prostu 784 niezależne liczby w ustalonej kolejności. Że da się zrobić lepiej — zachowując informację o sąsiedztwie — to temat sieci konwolucyjnych z Działu 12.
Krok 2: przez warstwy ukryte
Każdy z 784 neuronów wejściowych przekazuje swoją liczbę do każdego neuronu pierwszej warstwy ukrytej (powiedzmy, że ma ich 16). Neuron nr 1 tej warstwy liczy więc:
z = w₁·s₁ + w₂·s₂ + … + w₇₈₄·s₇₈₄ + b
czyli 784 mnożenia i tyleż dodawań, a potem przepuszcza wynik przez ReLU: ujemny — zero, dodatni — bez zmian. To samo robi każdy z pozostałych 15 neuronów tej warstwy, ale z własnym zestawem 784 wag — i to jest cała różnica między nimi. Wszystkie widzą ten sam obrazek, a każdy „patrzy" na niego inaczej, bo inne piksele traktuje poważnie.
W metaforze neuronów-ekspertów: każdy ekspert pierwszej warstwy ukrytej waży po swojemu informacje, które do niego docierają, przetwarza je i przekazuje wszystkim ekspertom warstwy następnej. Tam powtarza się to samo — z tą różnicą, że eksperci drugiej warstwy nie widzą już pikseli, a opinie ekspertów z warstwy pierwszej. Im dalej, tym bardziej przetworzona informacja; co konkretnie kryje się w tych opiniach, zobaczymy w Jednostce 10.4.
Krok 3: dziesięć neuronów wyjściowych
Warstwa wyjściowa ma 10 neuronów — po jednym na każdą cyfrę. Pierwszy jest „ekspertem od zera", drugi od jedynki, i tak dalej aż do dziewiątki. Każdy wypowiada się o swojej cyfrze i tylko o niej: liczy sumę ważoną opinii ostatniej warstwy ukrytej, a wynik przechodzi przez softmax (Jednostka 10.2), który zamienia dziesięć surowych liczb w dziesięć pewności sumujących się do 1.
Dla naszej siódemki dobrze wytrenowana sieć powinna dać coś w rodzaju:
| cyfra | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|---|
| pewność | 0,00 | 0,02 | 0,01 | 0,01 | 0,00 | 0,00 | 0,00 | 0,93 | 0,01 | 0,02 |
Odpowiedź sieci to klasa o największej pewności, czyli 7. Zauważ, że sieć nie zwraca „siódemki" — zwraca dziesięć liczb, a wybór największej z nich to już nasza decyzja, którą dopisujemy na końcu. I zauważ jeszcze, że drobne pewności przy 1 i 9 nie są przypadkiem: to cyfry, które przy niestarannym pisaniu bywają podobne do siódemki.
Ile to jest liczenia
Policzmy mnożenia dla jednej odpowiedzi w sieci 784 → 16 → 16 → 10:
- warstwa 1: 16 · 784 = 12 544
- warstwa 2: 16 · 16 = 256
- warstwa 3: 10 · 16 = 160
- razem około 13 tysięcy mnożeń na jedno rozpoznanie cyfry.
Dla współczesnego procesora to praca na mikrosekundy. Ale zwróć uwagę na strukturę tego rachunku: to nic innego jak mnożenie macierzy — te same działania, powtarzane miliony razy na niezależnych danych. Właśnie dlatego karty graficzne, zaprojektowane do masowo równoległego mnożenia liczb w grafice, okazały się idealnym narzędziem dla sieci neuronowych. To będzie sedno Jednostki 13.1.
Czym jest, a czym nie jest „pewność 93%"
Tu warto się zatrzymać, bo nieporozumienie w tym miejscu jest źródłem wielu przesadzonych doniesień o AI. Liczba 0,93 na wyjściu nie znaczy, że „w 93 przypadkach na 100 model ma rację". Znaczy tylko tyle: po przepuszczeniu tego obrazka przez wagi i softmax neuron siódemki dostał najwięcej. To wskaźnik wewnętrznej zgodności modelu z jego własnym treningiem, a nie oszacowanie prawdopodobieństwa prawdy.
Dwie konsekwencje, obie praktyczne. Pierwsza: modele bywają przesadnie pewne, bo softmax wyostrza różnice (zadanie 10.2.3), a trening nagradza pewne odpowiedzi. Druga, poważniejsza: sieć musi wybrać jedną z dziesięciu klas, bo takie ma wyjście. Pokaż jej zdjęcie kota, a odpowie „to jest cyfra 8, pewność 0,71" — i będzie to odpowiedź poprawnie policzona, tylko całkowicie bezsensowna. To zjawisko nazywa się działaniem poza rozkładem danych treningowych i jest jedną z najtrwalszych granic uczenia maszynowego (wracamy do niej w Jednostkach 12.5 i 18.1).
💭 Pomyśl: Sieć rozpoznająca cyfry dostaje obrazek, na którym ktoś napisał literę „S". Co zwróci? A gdybyś chciał, by system potrafił powiedzieć „to nie jest żadna cyfra" — co trzeba zmienić w sieci albo w sposobie użycia jej wyniku?
Sprawdź odpowiedź
Zwróci którąś cyfrę, najprawdopodobniej 5 albo 8 (litera S ma podobne krzywizny), z niemałą pewnością. Nie ma innej możliwości: warstwa wyjściowa ma dziesięć neuronów odpowiadających dziesięciu cyfrom, a softmax zawsze rozdzieli między nie całą jedynkę. W tej architekturze nie istnieje sposób wyrażenia odpowiedzi „nic z tego".
Trzy sposoby naprawy, każdy inny w duchu. (1) Dodać jedenastą klasę „nie-cyfra" i dostarczyć w treningu przykłady takich obrazków — czyli zmienić zadanie. (2) Ustawić próg odrzucenia: jeśli największa pewność jest niższa niż, powiedzmy, 0,8, system odpowiada „nie wiem" i przekazuje sprawę człowiekowi. To wykorzystanie progu decyzyjnego z Jednostki 9.4 i rozwiązanie tanie, choć zawodne przy modelach przesadnie pewnych. (3) Dołożyć osobny mechanizm wykrywania danych poza rozkładem, który ocenia, czy wejście przypomina cokolwiek z treningu, i to przed klasyfikacją.
Sam fakt, że trzeba to rozstrzygać osobno, jest ważny: „nie wiem" nie jest w sieciach neuronowych czymś danym z natury, tylko czymś, co trzeba świadomie zaprojektować.
⚠️ Uwaga, pułapka
Powiedzenie „sieć rozpoznaje cyfry" jest wygodnym skrótem, ale kryje pułapkę, którą warto sobie nazwać. Sieć nie rozpoznaje cyfr — sieć przekształca 784 liczby w 10 liczb tak, żeby na zbiorze, na którym ją uczono, najwyższa z tych dziesięciu wypadała zwykle we właściwym miejscu. Nie ma w niej pojęcia liczby, ilości ani pisania. Gdy przestawisz kolejność pikseli we wszystkich obrazkach (konsekwentnie, tym samym wzorem) i nauczysz sieć od nowa, będzie działać dokładnie tak samo dobrze — choć dla człowieka te obrazki będą już nieczytelną sieczką. To jeden z najostrzejszych testów na to, że „widzenie" sieci nie jest widzeniem.
📐 Definicje tej lekcji
- Przepływ w przód (forward pass) — obliczenie odpowiedzi sieci: przejście liczb od wejścia do wyjścia bez zmiany wag.
- Spłaszczenie — ustawienie pikseli obrazu w jeden ciąg liczb wejściowych.
- Normalizacja wejść — przeskalowanie wartości (np. 0–255 na 0–1) przed podaniem do sieci.
- Rozkład pewności — zestaw liczb na wyjściu klasyfikatora, sumujących się do 1.
- Działanie poza rozkładem — użycie modelu na danych niepodobnych do treningowych; model nadal odpowiada, ale bez sensu.
📌 Najważniejsze w pigułce
- Obrazek 28 × 28 to 784 liczby; warstwa wejściowa ma tyle neuronów, ile pikseli.
- Spłaszczenie gubi informację o sąsiedztwie pikseli (naprawiają to sieci konwolucyjne, Dział 12).
- Wszystkie neurony warstwy widzą to samo, a różnią się własnymi wagami — stąd różne „spojrzenia".
- Warstwa wyjściowa ma jeden neuron na klasę; softmax zamienia jej wyjścia w pewności sumujące się do 1.
- Jedna odpowiedź to około 13 tysięcy mnożeń — struktura mnożenia macierzy, idealna dla kart graficznych (13.1).
- Pewność 93% nie znaczy „mam rację w 93% przypadków" — to wewnętrzna zgodność modelu z treningiem.
- Sieć zawsze wybierze którąś z klas: „nie wiem" trzeba jej dodać osobno.
🎒 Zadania
Zadanie 10.3.1. Chcemy rozpoznawać kolorowe obrazki 64 × 64 piksele (trzy kanały barw: czerwony, zielony, niebieski) i klasyfikować je do 20 kategorii. (a) Ile neuronów musi mieć warstwa wejściowa, a ile wyjściowa? (b) Ile parametrów ma pierwsza warstwa ukryta, jeśli ma 128 neuronów? (c) Skomentuj wynik z punktu (b).
Pokaż rozwiązanie
(a) Warstwa wejściowa: 64 · 64 · 3 = 12 288 neuronów (każdy piksel to trzy liczby, po jednej na kanał). Warstwa wyjściowa: 20 neuronów, po jednym na kategorię.
(b) 128 · (12 288 + 1) = 1 572 992 parametry — ponad półtora miliona liczb w jednej warstwie.
(c) To pokazuje, dlaczego sieci gęste nie nadają się do obrazów o realnych rozmiarach: liczba parametrów rośnie proporcjonalnie do liczby pikseli razy liczba neuronów, więc przy zdjęciu 1000 × 1000 mielibyśmy setki milionów wag w pierwszej warstwie. Model tej wielkości wymaga ogromnych danych, żeby się nie przeuczyć (Jednostka 9.3), i marnuje informację o sąsiedztwie pikseli. Rozwiązaniem obu problemów naraz są sieci konwolucyjne (Dział 12), które współdzielą wagi między obszarami obrazu.
Zadanie 10.3.2. Sieć rozpoznająca cyfry dała następujące pewności: 0 → 0,02; 1 → 0,31; 2 → 0,04; 3 → 0,05; 4 → 0,08; 5 → 0,03; 6 → 0,02; 7 → 0,29; 8 → 0,06; 9 → 0,10. (a) Jaką odpowiedź zwróci system? (b) Czy powinien ją zwrócić? (c) Zaproponuj konkretną regułę postępowania w takich sytuacjach i uzasadnij ją.
Pokaż rozwiązanie
(a) Największa pewność to 0,31 przy cyfrze 1, więc system zwróci 1.
(b) Raczej nie powinien — a przynajmniej nie bez ostrzeżenia. Różnica między pierwszym (0,31) i drugim wyborem (0,29 przy siódemce) jest znikoma, a rozkład jest „rozmyty": żadna klasa nie zdobyła nawet jednej trzeciej pewności. To typowy obraz przypadku niejednoznacznego — na przykład niestarannie napisanej cyfry, którą i człowiek odczytałby różnie.
(c) Rozsądna reguła łączy dwa warunki: zwróć odpowiedź tylko wtedy, gdy największa pewność przekracza pewien próg (np. 0,6) i przewaga nad drugą klasą jest wyraźna (np. co najmniej 0,15). Inaczej zwróć „niejednoznaczne" i przekaż przypadek człowiekowi. Uzasadnienie: koszt pomyłki (źle odczytany numer konta na przelewie) jest zwykle nieporównanie wyższy niż koszt zapytania człowieka o jeden trudny przypadek — a to dokładnie sytuacja z Jednostki 9.4, w której świadomie oddajemy trochę „przepustowości" w zamian za precyzję.
Zadanie 10.3.3. Wyjaśnij, dlaczego sieć nauczona rozpoznawać cyfry pisane ręcznie przez Amerykanów może działać wyraźnie gorzej w Polsce. Wskaż konkretne różnice i powiąż odpowiedź z pojęciem z Jednostki 9.2.
Pokaż rozwiązanie
Powód to niereprezentatywność danych treningowych (Jednostka 9.2): zbiór uczący nie odzwierciedla populacji, w której model będzie używany. Konkretne różnice w zapisie cyfr są dobrze znane — w Polsce jedynkę pisze się zwykle z wyraźną ukośną „chorągiewką" u góry (w USA częściej jako samą pionową kreskę), siódemkę często z poprzeczką w poprzek (w USA rzadziej), a siódemka bez poprzeczki bywa u nas mylona z jedynką. Model, który nauczył się, że „pionowa kreska = 1", będzie systematycznie mylił polskie siódemki z jedynkami.
Zwróć uwagę na charakter tego błędu: nie jest losowy, ale systematyczny — dotyka konkretnej grupy użytkowników i konkretnych cyfr, więc uśredniona trafność na mieszanym zbiorze może wyglądać przyzwoicie i całkowicie ukryć problem. To argument za tym, żeby jakość mierzyć osobno w podgrupach, a nie tylko globalnie; wątek wraca przy uprzedzeniach modeli w Dziale 20.
🔍 Sprawdź, czy umiesz
- [ ] Opisać, jak obrazek 28 × 28 zamienia się w 784 liczby wejściowe.
- [ ] Wyjaśnić, co gubi spłaszczenie obrazu.
- [ ] Przejść krok po kroku przez przepływ w przód i wskazać, gdzie działa ReLU, a gdzie softmax.
- [ ] Uzasadnić liczbę neuronów w warstwie wejściowej i wyjściowej dla podanego zadania.
- [ ] Wyjaśnić, czego nie mówi „pewność 93%".
- [ ] Powiedzieć, co zrobi klasyfikator cyfr z obrazkiem, który nie jest cyfrą, i jak to naprawić.