Błąd i funkcja straty: skąd sieć wie, że się myli
🎯 Po co Ci to?
Człowiek uczący się na błędach ma coś, czego maszyna nie ma: poczucie, że coś nie wyszło. Wstyd, zdziwienie, „a przecież byłem pewien". Sieć neuronowa nie ma nic z tych rzeczy. Ma tylko liczby na wyjściu — i musi jakoś dowiedzieć się, że te liczby są złe.
Cała nauka maszyny stoi na jednym pomyśle: zamień „pomyliłem się" w jedną liczbę. Liczbę, którą można zmierzyć, porównać i — co najważniejsze — próbować zmniejszać. Ta liczba nazywa się stratą, a sposób jej liczenia to funkcja straty. To najbardziej niedoceniany element całego uczenia maszynowego: definiując funkcję straty, definiujesz, do czego model będzie dążył. A model nie będzie dążył do niczego innego.
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- wyjaśnić, czym jest funkcja straty i jaką rolę odgrywa w pętli treningu;
- policzyć stratę dla prostego przykładu regresji (średni błąd kwadratowy) i klasyfikacji (entropia krzyżowa);
- wyjaśnić, dlaczego entropia krzyżowa karze pewne pomyłki znacznie mocniej niż niepewne;
- odróżnić funkcję straty (co model minimalizuje) od miary jakości (jak my oceniamy model);
- wskazać, dlaczego źle postawiona funkcja straty daje model, który „działa idealnie" i jest bezużyteczny.
🔁 Przypomnij sobie
Z Jednostki 10.3 wiesz, jak sieć liczy odpowiedź: przepływ w przód i softmax na końcu, który zamienia surowe wyjścia w rozkład pewności sumujący się do 1. Z Jednostki 9.1 wiesz, że przykład treningowy to para: dane plus etykieta — czyli poprawna odpowiedź. Z Jednostki 9.4 wiesz, że „ile procent trafień" bywa miarą zwodniczą. Ta jednostka łączy te trzy rzeczy: mamy odpowiedź sieci, mamy odpowiedź poprawną — trzeba zmierzyć odległość między nimi.
📘 Pętla treningu: gdzie w niej siedzi strata
Trening sieci to powtarzanie w kółko czterech kroków. Rycina pokazuje całą pętlę:
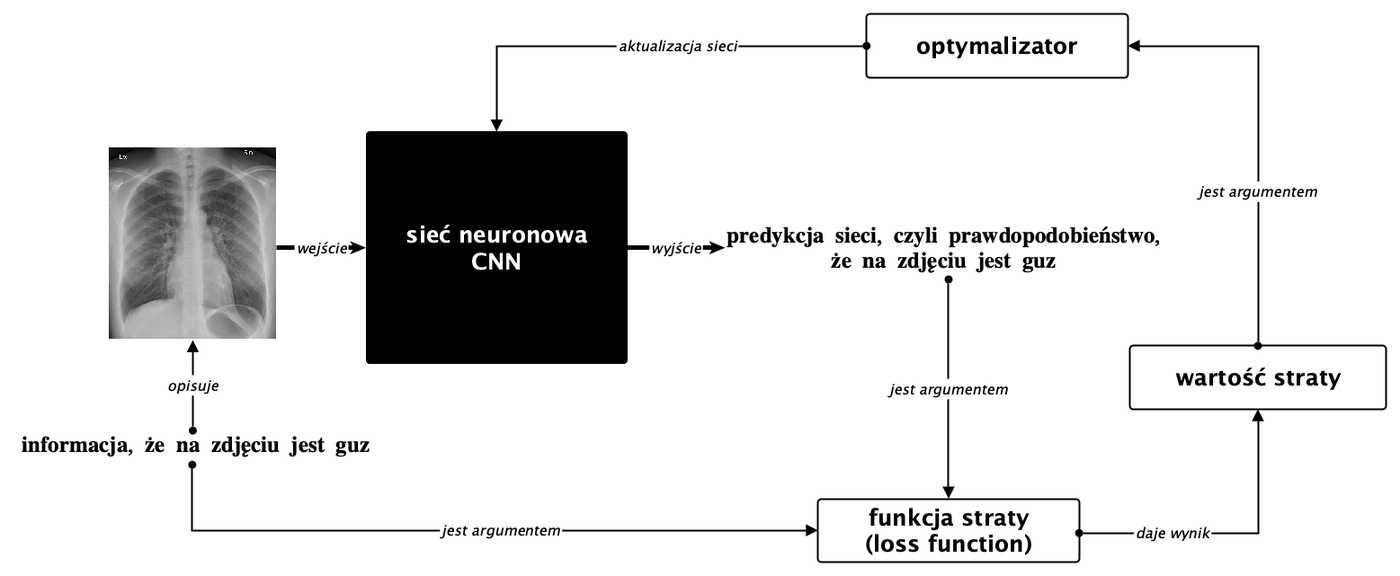
- Przykład wchodzi do sieci — obrazek, zdanie, wiersz tabeli.
- Sieć wydaje predykcję — przepływem w przód, na obecnych wagach (Jednostka 10.3).
- Funkcja straty porównuje predykcję z etykietą i zwraca jedną liczbę.
- Optymalizator zmienia wagi tak, żeby ta liczba przy następnym razie była mniejsza.
Punkt 3 to cała treść tej jednostki. Punkty 2 i 4 już znasz albo poznasz w kolejnych dwóch jednostkach. Zauważ, gdzie w tej pętli nie ma człowieka: nigdzie. Człowiek przygotował dane, ustawił architekturę i wybrał funkcję straty — potem pętla kręci się sama, miliony razy.
📘 Sieć się myli: konkretny przykład
Wróćmy do sieci rozpoznającej cyfry z Jednostki 10.3. Na wejście podajemy obrazek, na którym napisana jest siódemka. Dziesięć neuronów wyjściowych zwraca sumy ważone, a softmax zamienia je w pewności:
| Cyfra | Suma ważona | Pewność (softmax) |
|---|---|---|
| 0 | 2 | 3,2 % |
| 1 | 1 | 1,1 % |
| 2 | 0 | 0,4 % |
| 3 | 5 | 64,8 % |
| 4 | 1 | 1,1 % |
| 5 | 0 | 0,4 % |
| 6 | 0 | 0,4 % |
| 7 | 2 | 3,2 % |
| 8 | 1 | 1,1 % |
| 9 | 4 | 23,8 % |
Sieć jest w 65 % pewna, że widzi trójkę, w 24 % — że dziewiątkę. Prawdziwa odpowiedź, zapisana w etykiecie obrazka, to siódemka, której sieć przypisała nędzne 3,2 %.
Sieć nie „widzi", że się pomyliła. Widzi to funkcja straty: bierze cały rozkład pewności i jedną liczbę z etykiety, i zwraca miarę rozbieżności. Im bliżej prawdy, tym strata niższa; im dalej, tym wyższa. Tutaj strata będzie duża — i to jest właśnie sygnał, który za chwilę uruchomi korektę wag.
📘 Dwie straty, których używa się najczęściej
Funkcji straty jest wiele i dobiera się je do zadania. W praktyce dwie pokrywają większość przypadków.
Regresja (przewidujemy liczbę): średni błąd kwadratowy. Model przewiduje cenę mieszkania, my znamy prawdziwą. Bierzemy różnicę, podnosimy do kwadratu (żeby minus nie kasował plusa i żeby duże pomyłki bolały bardziej), i średnią po wszystkich przykładach:
strata = średnia z (przewidziane − prawdziwe)²
Trzy mieszkania: model mówi 500, 420, 610 tys.; prawda to 480, 500, 600. Różnice: +20, −80, +10. Kwadraty: 400, 6400, 100. Średnia: 2300. Zauważ, jak drugie mieszkanie zdominowało wynik — pomyłka cztery razy większa niż pierwsza daje wkład szesnaście razy większy. To celowe: kwadrat mówi „bardzo się mylić jest nieproporcjonalnie gorzej".
Klasyfikacja (przewidujemy kategorię): entropia krzyżowa. Tu model nie zwraca jednej liczby, ale rozkład pewności — jak w tabeli wyżej. Entropia krzyżowa robi rzecz, która na pierwszy rzut oka wygląda na oszustwo: patrzy wyłącznie na pewność przypisaną poprawnej odpowiedzi i bierze z niej ujemny logarytm.
strata = −log(pewność przypisana poprawnej odpowiedzi)
Cała reszta rozkładu jest ignorowana — i nie musi być brana pod uwagę, bo pewności sumują się do 1, więc podniesienie tej właściwej automatycznie obniża pozostałe. Wartości wyglądają tak:
| Pewność dla poprawnej odpowiedzi | Strata |
|---|---|
| 0,99 | 0,01 |
| 0,65 | 0,43 |
| 0,24 | 1,43 |
| 0,032 | 3,44 |
| 0,001 | 6,91 |
W naszym przykładzie z siódemką sieć dała poprawnej odpowiedzi 3,2 % — strata wynosi 3,44. Gdyby dała jej 65 %, strata spadłaby do 0,43. Gdyby dała 99 % — 0,01.
💭 Pomyśl
💭 Pomyśl: Dwóch uczniów odpowiada na to samo pytanie i oboje odpowiadają błędnie. Pierwszy mówi: „chyba trójka, ale nie jestem pewien, może dziewiątka". Drugi mówi: „to na pewno trójka, jestem pewien na sto procent". Który błąd jest poważniejszy — i dlaczego dobra funkcja straty powinna karać ich różnie?
Sprawdź odpowiedź
Poważniejszy jest błąd drugiego ucznia, choć treść odpowiedzi jest identyczna. Pierwszy uczeń myli się, ale wie, że nie wie — a to znaczy, że coś w jego rozumowaniu działa poprawnie: rozpoznaje własną niepewność i zostawia miejsce na inną możliwość. Drugi myli się i nie ma o tym pojęcia; jego pewność jest fałszywa, a więc podwójnie szkodliwa, bo na jej podstawie ktoś mógłby podjąć decyzję.
Entropia krzyżowa robi dokładnie to rozróżnienie, i robi je bardzo ostro. Uczeń, który poprawnej odpowiedzi dał 24 % pewności, dostaje stratę 1,43. Uczeń, który dał jej 0,1 %, dostaje 6,91 — prawie pięć razy więcej. A gdyby dał 0 %, strata byłaby nieskończona: logarytm zera nie istnieje. To nie przypadek ani techniczna dziwność, ale wpisana w funkcję straty zasada: nigdy nie bądź absolutnie pewien. Model uczony entropią krzyżową uczy się nie tylko trafiać, ale też kalibrować własną pewność — bo pewna pomyłka kosztuje go nieporównanie więcej niż pomyłka ostrożna. Ten sam mechanizm zobaczysz później po drugiej stronie: model językowy, który „na pewno" podaje nieistniejący fakt, jest groźniejszy od modelu, który się waha (Jednostka 19.2).
📘 Funkcja straty to nie to samo, co miara jakości
To rozróżnienie mylą nawet ludzie po kursie uczenia maszynowego, a jest kluczowe. Miara jakości (dokładność, precyzja, czułość — Jednostka 9.4) mówi nam, ludziom, czy model jest dobry. Funkcja straty mówi optymalizatorowi, w którą stronę zmieniać wagi. To dwie różne rzeczy i prawie nigdy nie są tą samą liczbą.
Dlaczego nie można po prostu minimalizować „liczby pomyłek"? Bo dokładność jest schodkowa. Wyobraź sobie, że zmieniasz jedną wagę o włos: pewność dla siódemki rośnie z 3,2 % na 3,3 %. Dokładność się nie zmienia — sieć wciąż wskazuje trójkę, wciąż się myli, liczba pomyłek jest identyczna. Z punktu widzenia dokładności ta zmiana nic nie dała, więc dokładność nie potrafi powiedzieć „idź dalej w tę stronę". Strata natomiast spadła: z 3,44 na 3,41. Drobna poprawa, ale mierzalna i wskazująca kierunek. Właśnie dlatego uczymy na stracie, a oceniamy miarą jakości: strata musi być czuła na małe zmiany, żeby dawała się schodzić krok po kroku (Jednostka 11.2).
Z tego wynika reguła, która ma konsekwencje daleko wychodzące poza matematykę: model dostaje dokładnie to, co zapisałeś w funkcji straty — nie to, co miałeś na myśli. Pamiętasz model wykrywający czerniaka, który naprawdę wykrywał linijkę przystawianą do groźnych zmian (Jednostka 9.3)? Z punktu widzenia funkcji straty ten model zachował się wzorowo: znalazł najprostszy wzorzec, który minimalizuje stratę na danych treningowych. Nikt mu nie powiedział „szukaj choroby" — powiedziano mu „minimalizuj tę liczbę". Zrobił to. Problem był w liczbie, nie w modelu. Ten sam mechanizm w większej skali wraca jako problem zgodności celów przy dużych modelach (Jednostka 19.4) i jako podstawa uczenia ze wzmacnianiem (Jednostka 13.4).
📐 DEFINICJA — funkcja straty: funkcja, która porównuje predykcję modelu z poprawną odpowiedzią i zwraca jedną liczbę mierzącą rozbieżność między nimi. Im niższa wartość, tym predykcje bliższe prawdzie. Cały trening to poszukiwanie takich parametrów, przy których strata na danych treningowych jest jak najmniejsza.
Po ludzku: miernik z jedną skalą, pokazujący „o ile się mylę" — jedyne źródło informacji, jakie model ma o swoim błędzie.
Czym to NIE jest: funkcja straty nie jest oceną modelu dla człowieka (do tego są miary jakości z Jednostki 9.4) i nie jest opisem tego, czego chcemy „w duchu" — jest dokładnym, dosłownym zapisem celu. Wszystko, czego w niej nie ma, dla modelu nie istnieje.
⚠️ Uwaga, pułapka
Pułapka pierwsza: „strata zero znaczy model idealny". Strata zero na zbiorze treningowym znaczy, że model perfekcyjnie odtwarza dane, które widział — co jest raczej ostrzeżeniem niż powodem do radości. Podręcznikowy przypadek przeuczenia (Jednostka 9.3) to właśnie strata bliska zera na treningu przy stracie rosnącej na walidacji. Dlatego w praktyce śledzi się dwie krzywe straty naraz i patrzy się na tę drugą.
Pułapka druga: porównywanie wartości straty między różnymi zadaniami. „Mój model ma stratę 0,3, a twój 1,4, więc mój jest lepszy" — to zdanie prawie zawsze jest bezsensowne. Wartość straty zależy od użytej funkcji, od liczby klas, od skali danych. Średni błąd kwadratowy na cenach mieszkań w złotówkach da liczby w milionach; ten sam model na cenach w milionach złotych da liczby małe. Strata służy do porównywania tego samego modelu z sobą samym w czasie, a nie modeli między sobą.
🌍 Powiązania
Masz liczbę mierzącą błąd. Zostało pytanie, jak z jednej liczby wyczytać, w którą stronę przekręcić każdą z tysięcy wag — to Jednostka 11.2. Zbiór miar, którymi oceniamy model po treningu, to Jednostka 9.4; diagnostyka na podstawie dwóch krzywych straty — Jednostka 9.3. Wątek „model realizuje zapisany cel, nie zamierzony" wraca w mocnej postaci przy uczeniu ze wzmacnianiem (Jednostka 13.4) i przy dostrajaniu modeli językowych do ludzkich preferencji (Jednostka 17.4).
📐 Definicje tej lekcji
- Funkcja straty (funkcja błędu) — funkcja zwracająca jedną liczbę mierzącą rozbieżność między predykcją modelu a poprawną odpowiedzią.
- Średni błąd kwadratowy (MSE) — strata dla zadań regresji: średnia z kwadratów różnic między przewidzianymi i prawdziwymi wartościami.
- Entropia krzyżowa — strata dla zadań klasyfikacji: ujemny logarytm pewności przypisanej poprawnej klasie.
- Optymalizator — element treningu, który na podstawie wartości straty zmienia parametry sieci.
- Kalibracja pewności — zgodność deklarowanej pewności modelu z częstością, z jaką faktycznie ma rację.
📌 Najważniejsze w pigułce
- Sieć nie „czuje" błędu — potrzebuje go jako jednej liczby. Tę liczbę daje funkcja straty.
- Regresja: średni błąd kwadratowy (kwadrat sprawia, że duże pomyłki bolą nieproporcjonalnie mocniej). Klasyfikacja: entropia krzyżowa (patrzy tylko na pewność przypisaną poprawnej odpowiedzi).
- Entropia krzyżowa karze pewne pomyłki dużo mocniej niż niepewne — dzięki temu model uczy się też ostrożności, nie tylko trafiania.
- Strata ≠ miara jakości. Dokładność jest schodkowa i nie wskazuje kierunku poprawy; strata jest czuła na drobne zmiany wag, dlatego to na niej uczymy.
- Model realizuje funkcję straty dosłownie. Model wykrywający linijkę zamiast czerniaka nie zawiódł — dostał źle postawiony cel.
- Strata zero na treningu to sygnał ostrzegawczy (przeuczenie), a wartości straty nie porównuje się między różnymi zadaniami.
🎒 Zadania
Zadanie 11.1.1. Model przewiduje temperaturę na następny dzień. Dla czterech dni przewidział 21, 18, 25, 30 °C; naprawdę było 20, 22, 24, 24 °C. Policz średni błąd kwadratowy. Następnie wskaż, który dzień odpowiada za największą część wyniku, i wyjaśnij, dlaczego funkcja straty tak mocno go wyróżnia.
Pokaż rozwiązanie
Różnice (przewidziane − prawdziwe): +1, −4, +1, +6. Kwadraty: 1, 16, 1, 36. Suma: 54. Średnia z czterech: 13,5.
Największy wkład ma dzień czwarty — samo 36 to dwie trzecie całej sumy 54. Podniesienie różnicy do kwadratu sprawia, że pomyłka sześciostopniowa waży trzydzieści sześć razy więcej niż pomyłka jednostopniowa, a nie sześć razy więcej. To celowa własność: przy przewidywaniu temperatury (albo ceny, albo dawki leku) pomyłka o sześć stopni jest znacznie gorsza niż sześć pomyłek o jeden stopień — pierwsza może oznaczać zły ubiór albo zmarnowaną decyzję, druga jest praktycznie nieodczuwalna. Kwadrat wpisuje tę asymetrię w cel treningu, więc model będzie się starał przede wszystkim unikać dużych wpadek.
Zadanie 11.1.2. Dwa modele klasyfikują to samo zdjęcie kota. Model A daje: kot 0,55, pies 0,40, koń 0,05. Model B daje: kot 0,95, pies 0,04, koń 0,01. Oba trafiły. Policz entropię krzyżową dla obu (przyjmij log naturalny; wystarczy przybliżenie na podstawie tabeli z lekcji) i wyjaśnij, dlaczego trening będzie nadal poprawiał model A, choć ten się nie pomylił.
Pokaż rozwiązanie
Model A: strata = −log(0,55) ≈ 0,60. Model B: strata = −log(0,95) ≈ 0,05. Oba modele mają dokładność 100 % na tym przykładzie, ale ich strata różni się dwunastokrotnie.
To pokazuje istotę różnicy między stratą a dokładnością. Dokładność mówi „trafione, koniec sprawy" i nie ma nic więcej do dodania — więc gdyby uczyć na dokładności, model A nie dostałby żadnego sygnału do poprawy. Entropia krzyżowa mówi: „trafiłeś, ale ledwo; byłeś prawie równie skłonny powiedzieć pies". Dopóki pewność dla poprawnej klasy nie jest bliska 1, strata jest wyraźnie większa od zera, więc gradient wciąż popycha wagi w stronę pewniejszej odpowiedzi. Dzięki temu trening nie zatrzymuje się w momencie „już nie robię błędów", tylko doprowadza model do stanu, w którym poprawne odpowiedzi są wyraźnie oddzielone od błędnych — co bardzo pomaga na nowych, trudniejszych przykładach.
Zadanie 11.1.3. Szkoła chce modelu przewidującego, którzy uczniowie są zagrożeni niezaliczeniem roku, żeby zaproponować im pomoc. Zespół ustawia funkcję straty tak, by minimalizowała łączną liczbę pomyłek. W szkole 5 % uczniów jest realnie zagrożonych. Wyjaśnij, jaki model minimalizuje taką stratę prawie idealnie, dlaczego jest bezużyteczny i jak zmieniłbyś funkcję straty.
Pokaż rozwiązanie
Stratę „łączna liczba pomyłek" minimalizuje niemal idealnie model, który o każdym uczniu mówi: nie jest zagrożony. Myli się wtedy w 5 % przypadków, czyli osiąga 95 % dokładności — wynik, który w raporcie wygląda znakomicie. Model jest jednak całkowicie bezużyteczny: nie wskazuje ani jednego ucznia do pomocy, więc nie realizuje jedynego celu, dla którego go zbudowano.
Źródłem błędu nie jest algorytm, ale postawiony cel: funkcja straty traktuje oba rodzaje pomyłek jednakowo, choć w tym zadaniu są dramatycznie nierówne. Pominięcie ucznia realnie zagrożonego to szkoda poważna i trudna do odwrócenia; niepotrzebne zaproszenie ucznia na konsultacje to koszt drobny. Naprawa polega na wpisaniu tej asymetrii w stratę — na przykład przez wagi klas (pomyłka na uczniu zagrożonym liczona kilkanaście razy mocniej) albo przez optymalizowanie miary, która jest wrażliwa na klasę rzadką (czułość przy zadanym poziomie precyzji, Jednostka 9.4). Warto zauważyć, że to nie jest decyzja techniczna: proporcja kar odpowiada odpowiedzi na pytanie „ile fałszywych alarmów jesteśmy gotowi przyjąć za jednego uratowanego ucznia", a to pytanie wychowawcze i etyczne, nie matematyczne (Dział 20).
🔍 Sprawdź, czy umiesz
- [ ] Wskazać, w którym miejscu pętli treningu działa funkcja straty i co robi optymalizator.
- [ ] Policzyć średni błąd kwadratowy dla kilku przykładów i wyjaśnić rolę podniesienia do kwadratu.
- [ ] Policzyć entropię krzyżową z pewności przypisanej poprawnej klasie i wyjaśnić, dlaczego pewna pomyłka kosztuje najwięcej.
- [ ] Wyjaśnić, dlaczego nie uczymy modelu wprost na dokładności.
- [ ] Podać przykład źle postawionej funkcji straty i pokazać, jaki „idealny" i bezużyteczny model ją minimalizuje.