Propagacja wsteczna: jak sieć uczy się na błędach
🎯 Po co Ci to?
To jest jednostka, w której noga neuronowa naprawdę wybudza się z zimy. W 1969 roku Minsky i Papert pokazali, że pojedynczy Perceptron ma fundamentalne ograniczenie, ale sami zauważyli, że sieć z dodatkową warstwą neuronów „w środku" mogłaby to ominąć — problemem był brak metody, jak taką sieć skutecznie wytrenować. W tej jednostce poznasz metodę, która ten problem rozwiązała: propagację wsteczną. To dziś fundament praktycznie każdej sieci neuronowej na świecie — od rozpoznawania obrazów po duże modele językowe.
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- opisać dwa kierunki jednej iteracji treningu: przepływ w przód i przepływ wstecz;
- wyjaśnić, na czym polega problem przypisania winy w sieci z warstwami ukrytymi;
- opisać ogólną ideę propagacji wstecznej: jak błąd na wyjściu prowadzi do korekty wag w warstwach wcześniejszych;
- wyjaśnić, czym w tej maszynerii jest optymalizator i skąd bierze informację o kierunku zmian;
- wskazać, kto i kiedy spopularyzował tę metodę oraz kto wcześniej odkrył jej matematyczne podstawy.
🔁 Przypomnij sobie
Z Jednostki 11.1 masz funkcję straty — jedną liczbę mówiącą, o ile sieć się pomyliła. Z Jednostki 11.2 wiesz, że poprawa wag polega na drobnym kroku w kierunku przeciwnym do gradientu, czyli że dla każdej wagi potrzebujesz jednej liczby: „o ile zmieni się strata, gdy tę wagę podniosę o włos". W Jednostce 11.2 pominęliśmy jednak rzecz najtrudniejszą: skąd te liczby wziąć dla wagi, która siedzi w środku sieci. Tu ją nadrobimy.
Warto też wrócić do Jednostki 8.4 i kluczowego zastrzeżenia Minsky'ego i Paperta: sieć z dodatkową warstwą ukrytą teoretycznie mogłaby obliczyć XOR, ale w 1969 roku nikt nie znał praktycznej metody, jak taką wielowarstwową sieć wytrenować. Ta jednostka daje odpowiedź na dokładnie to pytanie.
📘 Jedna iteracja ma dwa kierunki
Trening sieci to powtarzanie w kółko ruchu tam i z powrotem. Rycina pokazuje oba kierunki naraz — strzałka w prawo to przepływ w przód, strzałka w lewo to przepływ wstecz:
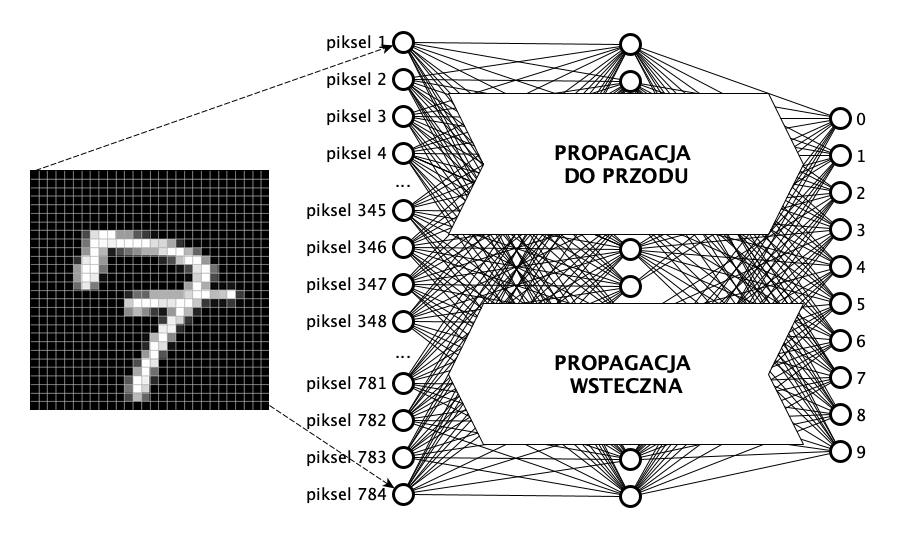
W przód — to już znasz z Jednostki 10.3: neurony każdej warstwy przyjmują wartości od wszystkich neuronów warstwy poprzedniej, ważą je, sumują, przepuszczają przez funkcję aktywacji i podają dalej. Na końcu softmax zamienia wyjścia w rozkład pewności, a funkcja straty porównuje go z etykietą. Efekt: jedna liczba błędu.
Wstecz — tę liczbę odbiera optymalizator, którego jedynym zadaniem jest zmienić wagi tak, żeby następnym razem strata była mniejsza. Ale optymalizator sam z siebie nie wie, które wagi zawiniły; wie tylko, jak zmienić wagę, gdy dostanie dla niej gradient. Tych gradientów — po jednym na każdą wagę w sieci — dostarcza mu właśnie algorytm propagacji wstecznej. To podział pracy, który warto trzymać w głowie: propagacja wsteczna liczy winę, optymalizator wykonuje karę.
Na początku treningu wszystkie wagi mają wartości losowe, zwykle bardzo małe — co można czytać jako początkowy sceptycyzm neuronu wobec wszystkich sygnałów, jakie do niego dochodzą. Cała treść modelu powstaje dopiero z powtarzania tej pętli: przykład, predykcja, strata, korekta. Przykład, predykcja, strata, korekta. Tysiące i miliony razy.
📘 Problem przypisania winy
Dla ostatniej warstwy sprawa jest prosta: porównujemy jej wyjście z poprawną odpowiedzią wprost, więc widać, o ile każda z jej wag pociągnęła wynik w złą stronę. Kłopot zaczyna się głębiej. Waga w pierwszej warstwie nie dotyka wyniku bezpośrednio — jej wpływ przechodzi przez warstwę drugą, potem trzecią, gdzie po drodze miesza się z wpływem tysięcy innych wag i przechodzi przez funkcje aktywacji. Jak w takim gąszczu ustalić, ile z końcowego błędu przypada właśnie na nią?
To pytanie nazywa się problemem przypisania winy (ang. credit assignment problem) i przez siedemnaście lat po pracy Minsky'ego i Paperta było głównym powodem, dla którego sieci wielowarstwowe pozostawały teoretyczną możliwością, a nie działającym narzędziem.
Odpowiedzią jest propagacja wsteczna (ang. backpropagation): metoda, która najpierw oblicza błąd na wyjściu sieci, a potem — korzystając z reguły łańcuchowej znanej z rachunku różniczkowego — systematycznie „przekazuje" ten błąd wstecz, warstwa po warstwie, od wyjścia do wejścia, obliczając dokładnie, jak mocno każda pojedyncza waga w każdej warstwie przyczyniła się do końcowego błędu. Dzięki temu każda waga w całej sieci — niezależnie od tego, jak głęboko jest „schowana" — dostaje precyzyjną wskazówkę, w którą stronę i o ile ją skorygować.
💭 Pomyśl: Wyobraź sobie zespół trzech osób pracujących jedna po drugiej nad tym samym zadaniem: pierwsza przygotowuje surowe dane, druga je przetwarza, trzecia wydaje ostateczny werdykt. Werdykt okazuje się błędny. Jak — bez podważania każdej osoby po kolei od zera — sprawiedliwie rozdzielić „winę" za błąd między te trzy osoby, wiedząc dokładnie, jak wynik pracy jednej osoby wpływał na pracę następnej?
Sprawdź odpowiedź
Trzeba zacząć od ostatniej osoby (najbliżej wyniku) i zapytać: „gdybyś dostała nieco inne dane wejściowe od poprzedniczki, jak bardzo zmieniłby się Twój werdykt?" — to mówi, jak mocno błąd trzeciej osoby zależy od tego, co dostała od drugiej. Potem przechodzisz do drugiej osoby z tym samym pytaniem względem pierwszej, i tak dalej, aż dotrzesz do samego początku łańcucha. Na każdym kroku „przekazujesz" informację o błędzie do tyłu, mnożąc ją przez to, jak mocno dana osoba wpływała na kolejną. To dokładnie logika propagacji wstecznej: błąd „przepływa" wstecz przez sieć, warstwa po warstwie, i na każdym etapie mówi dokładnie, o ile trzeba skorygować wkład tej konkretnej warstwy w końcowy wynik.
📐 DEFINICJA — propagacja wsteczna (backpropagation): algorytm trenowania wielowarstwowych sieci neuronowych, który oblicza błąd na wyjściu sieci, a następnie systematycznie „przekazuje" go wstecz przez kolejne warstwy, precyzyjnie wyliczając, jak bardzo każda pojedyncza waga w sieci przyczyniła się do tego błędu — czyli dostarcza gradient, którym optymalizator wykonuje krok spadku gradientu (Jednostka 11.2).
Po ludzku: to sposób na sprawiedliwe „rozdzielenie winy" za błąd sieci między wszystkie jej wagi, niezależnie od tego, jak głęboko są „ukryte" w środkowych warstwach.
Matematyczne podstawy tej metody istniały już wcześniej — elementy tej samej idei pojawiały się niezależnie u kilku badaczy, m.in. Paula Werbosa (1974) i fińskiego matematyka Seppo Linnainmaa (1970), choć w innym kontekście i bez większego rozgłosu. Prawdziwy przełom nastąpił w 1986 roku, gdy David Rumelhart, Geoffrey Hinton i Ronald Williams opublikowali artykuł, który jasno pokazał — i, co ważne, spopularyzował w szerokim środowisku badawczym — że propagacja wsteczna praktycznie działa, ucząc wielowarstwowe sieci rozwiązywać zadania niedostępne dla pojedynczego Perceptronu, łącznie z tym samym XOR-em, który pokonał Rosenblatta.
⚠️ Uwaga, pułapka
Częsty błąd: myślenie, że propagacja wsteczna została „wynaleziona" dopiero w 1986 roku, jakby wcześniej nikt o niej nie słyszał. W rzeczywistości matematyczne mechanizmy leżące u jej podstaw (reguła łańcuchowa różniczkowania) były znane od dawna, a poszczególne elementy metody odkrywano niezależnie kilkukrotnie już od lat 60. i 70. XX wieku. To, co zdarzyło się w 1986 roku, to nie odkrycie matematyki od zera, lecz przekonujące pokazanie środowisku badawczemu, że ta metoda praktycznie działa na realnych sieciach i realnie rozwiązuje problemy, które przez lata uchodziły za nierozwiązywalne. Rozróżnienie „kto pierwszy coś matematycznie wyprowadził" od „kto sprawił, że świat na to zwrócił uwagę i zaczął tego używać" jest w historii nauki bardzo istotne — i powtórzy się w tej książce jeszcze nieraz, m.in. przy sieciach splotowych (Dział 12).
🌍 Powiązania
Propagacja wsteczna to narzędzie ogólne — działa dla sieci o dowolnej architekturze, o ile tylko da się przez nią policzyć gradient. Dzięki temu wszystkie architektury z dalszych działów (sieci konwolucyjne, rekurencyjne, transformatory) uczą się tym samym mechanizmem; różnią się układem połączeń, nie sposobem uczenia. To jedna z najważniejszych rzeczy do zapamiętania z całej Części III.
Zostały jeszcze dwie sprawy. Optymalizator dostaje gradienty — ale jak duży krok ma zrobić, ile przykładów obejrzeć przed korektą i ile razy przejść przez cały zbiór? To Jednostka 11.4. A co się psuje, gdy sygnał błędu wraca przez wiele warstw i po drodze wygasa — Jednostka 11.5.
📐 Definicje tej lekcji
- Przepływ w przód — obliczenie odpowiedzi sieci na obecnych wagach, od wejścia do wyjścia.
- Problem przypisania winy — pytanie, jaki udział w końcowym błędzie ma konkretna waga w warstwie ukrytej.
- Propagacja wsteczna (backpropagation) — algorytm obliczający wkład każdej wagi w błąd sieci przez systematyczne przekazywanie błędu od wyjścia do wejścia; spopularyzowany przez Rumelharta, Hintona i Williamsa (1986).
- Reguła łańcuchowa — zasada rachunku różniczkowego pozwalająca policzyć wpływ ogniwa na wynik całego łańcucha przez przemnożenie wpływów kolejnych ogniw.
- Optymalizator — element treningu, który mając gradienty, wykonuje faktyczną zmianę wag.
📌 Najważniejsze w pigułce
- Jedna iteracja treningu ma dwa kierunki: w przód (przykład → predykcja → strata) i wstecz (strata → gradienty → korekta wag).
- Podział pracy: propagacja wsteczna liczy winę, optymalizator wykonuje karę.
- Problem przypisania winy — jak ocenić udział wagi ukrytej w środku sieci — blokował dziedzinę siedemnaście lat.
- Propagacja wsteczna rozwiązuje go regułą łańcuchową: przekazuje błąd wstecz warstwa po warstwie, mnożąc po drodze wpływy kolejnych ogniw.
- Wagi startowe są losowe; cała treść modelu powstaje z powtarzania pętli miliony razy.
- Matematyczne podstawy istniały wcześniej (Linnainmaa 1970, Werbos 1974), ale to Rumelhart, Hinton i Williams (1986) przekonująco pokazali, że metoda praktycznie działa.
- Ten sam mechanizm uczy wszystkie późniejsze architektury — różnią się połączeniami, nie sposobem uczenia.
🎒 Zadania
Zadanie 11.3.1. Wypisz po kolei, co dzieje się z jednym obrazkiem cyfry od momentu podania go na wejście sieci do momentu zmiany wag. Przy każdym kroku zaznacz, czy należy do przepływu w przód, czy wstecz, i wskaż, w którym momencie w ogóle pojawia się informacja o poprawnej odpowiedzi.
Pokaż rozwiązanie
W przód: (1) obrazek zamienia się w ciąg liczb (jasności pikseli) i wchodzi do warstwy wejściowej; (2) każda kolejna warstwa waży otrzymane sygnały, sumuje je, dodaje obciążenie i przepuszcza przez funkcję aktywacji; (3) warstwa wyjściowa przez softmax zwraca rozkład pewności dla dziesięciu cyfr.
Punkt zwrotny: (4) funkcja straty porównuje ten rozkład z etykietą obrazka i zwraca jedną liczbę błędu. To jest dokładnie ten moment, w którym poprawna odpowiedź pojawia się w całym procesie — i jest to ważne: podczas przepływu w przód sieć nie ma dostępu do prawidłowej odpowiedzi, liczy wyłącznie na podstawie wag. Etykieta wchodzi do gry dopiero jako materiał do porównania.
Wstecz: (5) propagacja wsteczna przelicza błąd od warstwy wyjściowej wstecz, wyznaczając dla każdej wagi jej gradient; (6) optymalizator, mając gradienty, koryguje każdą wagę o mały krok w kierunku obniżającym stratę. Potem cykl zaczyna się od nowa z następnym obrazkiem.
Warto dodać uwagę, którą łatwo przeoczyć: po zakończeniu treningu, gdy model działa u użytkownika, wykonywany jest wyłącznie przepływ w przód. Etykiet nie ma, funkcji straty nikt nie liczy, wagi się nie zmieniają. Model używany nie uczy się — dlatego nie „pamięta" tego, co mu napisałeś (Jednostka 17.3).
Zadanie 11.3.2. Sieć ma trzy warstwy: wejściową, ukrytą i wyjściową. Błąd obliczono na warstwie wyjściowej. Wyjaśnij, dlaczego nie można od razu, bez dodatkowych obliczeń, skorygować wag między warstwą wejściową a ukrytą tak samo prosto, jak koryguje się wagi tuż przed warstwą wyjściową.
Pokaż rozwiązanie
Wagi tuż przed warstwą wyjściową mają bezpośredni wpływ na błąd — łatwo policzyć, jak zmiana każdej z nich wpłynie na wynik końcowy, bo nic nie stoi „pomiędzy". Natomiast wagi między warstwą wejściową a ukrytą wpływają na błąd pośrednio — ich efekt najpierw przechodzi przez warstwę ukrytą (i jej własne przekształcenie sygnału), zanim w ogóle dotrze do warstwy wyjściowej. Żeby poprawnie ocenić, jak mocno taka „daleka" waga przyczyniła się do końcowego błędu, trzeba matematycznie uwzględnić cały łańcuch wpływów po drodze — dokładnie to robi propagacja wsteczna, przekazując informację o błędzie krok po kroku wstecz przez każdą warstwę, zamiast próbować policzyć wpływ „na skróty".
Zadanie 11.3.3. Dlaczego historycy nauki uznają rok 1986 (Rumelhart, Hinton, Williams), a nie wcześniejsze prace Werbosa czy Linnainmaa, za punkt zwrotny dla propagacji wstecznej? Czy to sprawiedliwe wobec wcześniejszych badaczy?
Pokaż rozwiązanie
To pytanie otwarte, ale kluczowy argument brzmi: matematyczne odkrycie i praktyczne przekonanie środowiska naukowego, że dana metoda naprawdę rozwiązuje realne problemy, to dwie różne rzeczy — i obie mają wartość, choć różnego rodzaju. Werbos i Linnainmaa wyprowadzili matematyczne podstawy wcześniej, ale ich prace pozostały mało zauważone (m.in. dlatego, że powstały w okresie zimy sieci neuronowych, gdy niewielu badaczy w ogóle śledziło ten temat, oraz w publikacjach o ograniczonym zasięgu). Rumelhart, Hinton i Williams pokazali metodę w kontekście realnie działających eksperymentów, jasno wytłumaczyli jej znaczenie i opublikowali w miejscu, które dotarło do szerokiego grona badaczy — to właśnie ich publikacja „odmroziła" całe zainteresowanie sieciami neuronowymi. Sprawiedliwe podejście historyczne to uznanie obu wkładów: wcześniejszego matematycznego pierwszeństwa i późniejszej praktycznej popularyzacji — nie traktowanie jednego jako „ważniejszego" kosztem całkowitego pominięcia drugiego.
🔍 Sprawdź, czy umiesz
- [ ] Opisać dwa kierunki jednej iteracji treningu i wskazać, w którym momencie pojawia się etykieta.
- [ ] Wyjaśnić, na czym polega problem przypisania winy i dlaczego nie występuje przy jednym neuronie.
- [ ] Opisać ogólną ideę propagacji wstecznej — jak błąd „wraca" przez warstwy sieci.
- [ ] Rozdzielić role: co robi propagacja wsteczna, a co optymalizator.
- [ ] Wskazać, kto i kiedy spopularyzował tę metodę, oraz kto wcześniej odkrył jej matematyczne podstawy.