Obraz jako liczby: piksele, kanały, rozdzielczość
🎯 Po co Ci to?
Zdanie „sieć rozpoznaje obrazy" jest wygodnym skrótem, który zaciera rzecz najważniejszą: do sieci nie wchodzi obraz. Wchodzi tabela liczb. Wszystko, co dalej się dzieje — mnożenia, sumy, korekty wag — dzieje się na liczbach i nie ma nic wspólnego z patrzeniem.
Zanim więc zobaczysz, jak działa sieć konwolucyjna, musimy ustalić dwie rzeczy: czym jest obraz dla komputera oraz dlaczego sieć gęsta z Działu 10 przestaje sobie z nim radzić, gdy obrazek przestaje być malutki. Drugi z tych powodów jest znacznie ciekawszy od pierwszego — i to on wymusił nową architekturę.
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- opisać obraz cyfrowy jako tablicę liczb: piksele, skala szarości 0–255, kanały RGB;
- policzyć, ile liczb wchodzi do sieci przy danej rozdzielczości;
- policzyć liczbę wag pierwszej warstwy sieci gęstej dla zdjęcia i pokazać, że jest nie do utrzymania;
- wyjaśnić drugi, poważniejszy problem: sieć gęsta nic nie wie o sąsiedztwie pikseli;
- wyjaśnić, czym jest niezmienniczość na przesunięcie i dlaczego bez niej rozpoznawanie obrazów jest kruche.
🔁 Przypomnij sobie
Z Jednostki 10.3 wiesz, jak wyglądała sieć rozpoznająca cyfry: obrazek 28 × 28 rozłożono na 784 liczby, każda trafiła do jednego neuronu warstwy wejściowej, a na końcu softmax dawał dziesięć pewności. Z Jednostki 11.4 wiesz, że każdy parametr trzeba poprawiać w każdej iteracji treningu, więc ich liczba to koszt liczony w czasie i prądzie. Z Jednostki 9.3 wiesz, że model o zbyt wielu parametrach względem liczby danych przeucza się. Te trzy fakty zaraz się spotkają.
📘 Piksel to liczba, nie kolorowy kwadracik
Obraz cyfrowy jest siatką pikseli, a piksel jest liczbą (albo kilkoma liczbami). W obrazie w odcieniach szarości jeden piksel to jedna liczba od 0 do 255: 0 to czarny, 255 to biały, wartości pośrednie to szarości. Obrazek MNIST ma 28 pikseli wysokości i 28 szerokości, czyli 28 · 28 = 784 liczby — i dokładnie tyle wejść miała nasza sieć z Jednostki 10.3.
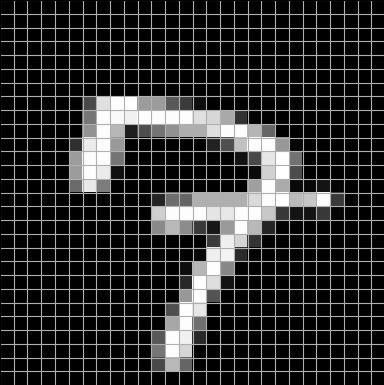
Obraz kolorowy potrzebuje trzech liczb na piksel: ile w nim czerwonego, ile zielonego, ile niebieskiego (RGB). Mówimy wtedy, że obraz ma trzy kanały, albo — obrazowo — że jest siatką o głębokości 3: trzy warstwy liczb ułożone jedna na drugiej, każda o wymiarach obrazu. Dane wejściowe stają się więc strukturą trójwymiarową: wysokość × szerokość × głębokość.
📐 DEFINICJA — piksel: najmniejszy element obrazu cyfrowego; dla komputera jedna liczba (obraz w skali szarości) albo trzy liczby RGB (obraz kolorowy).
Po ludzku: jedno pole na siatce, na którym zapisano „jak jasno tu jest".
📐 DEFINICJA — kanał: jedna z warstw liczb opisujących ten sam obraz. Obraz w skali szarości ma jeden kanał, kolorowy — trzy (R, G, B).
Czym to NIE jest: kanał to nie to samo co warstwa sieci. Kanały są własnością danych, warstwy — własnością modelu.
📐 DEFINICJA — rozdzielczość: liczba pikseli obrazu, podawana jako wysokość × szerokość (np. 1920 × 1080).
Ile to daje liczb na wejściu? Rachunek jest banalny i właśnie dlatego pouczający:
   28 ×   28 × 1   (obrazek MNIST)          =        784 liczby
  224 ×  224 × 3   (typowe wejście CNN)     =    150 528 liczb
 1920 × 1080 × 3   (jedna klatka Full HD)   =  6 220 800 liczb
 4000 × 3000 × 3   (zdjęcie z telefonu)     = 36 000 000 liczb
📘 Pierwszy problem: rachunek, który nie domyka się
Załóżmy, że chcemy podać sieci gęstej zdjęcie 224 × 224 w kolorze, czyli 150 528 liczb, i że pierwsza warstwa ukryta ma 1000 neuronów — skromnie, jak na zadanie „rozpoznaj, co jest na zdjęciu". W sieci gęstej każdy neuron łączy się z każdym wejściem, więc liczba wag tej jednej warstwy to:
150 528 × 1000 = 150 528 000 — ponad sto pięćdziesiąt milionów parametrów. W jednej warstwie. Sieć ma ich mieć kilkanaście.
Trzy skutki, wszystkie złe. Po pierwsze pamięć i czas: każdy z tych parametrów trzeba trzymać i w każdej iteracji poprawiać (Jednostka 11.4). Po drugie dane: model o stu milionach swobody dopasuje się do szczegółów zbioru treningowego, jeśli tych danych nie będzie astronomicznie wiele — czyli przeuczy się (Jednostka 9.3). Po trzecie absurd: my potrafimy rozpoznać kota, nie mając w głowie stu milionów niezależnych pokręteł. Coś w tym rozwiązaniu jest po prostu źle postawione.
📘 Drugi problem, poważniejszy: sieć gęsta nie wie, co jest obok czego
Ten jest subtelniejszy i to on właściwie wymusił nową architekturę.
Zrób następujący eksperyment myślowy. Weź zbiór treningowy MNIST i przetasuj piksele — losowo, ale tak samo w każdym obrazku: piksel numer 1 idzie na miejsce 512, piksel 2 na miejsce 37 i tak dalej. Człowiek po takim zabiegu nie rozpozna niczego; zobaczy śnieg. A sieć gęsta? Wytrenuje się dokładnie tak samo dobrze. Bo dla niej wejście to worek 784 liczb bez struktury: kolejność wejść nie ma żadnego znaczenia, byle była konsekwentna.
To bardzo mocny sygnał: skoro architekturze wolno przetasować piksele bez straty, to znaczy, że nie korzysta z sąsiedztwa. A sąsiedztwo jest w obrazie informacją pierwszorzędną — krawędź to właśnie różnica jasności między pikselami stojącymi obok siebie. Sieć gęsta może się tego domyślić z danych, ale musi się tego uczyć od zera, płacąc parametrami i przykładami za wiedzę, którą dałoby się wpisać w architekturę za darmo.
Jest jeszcze konsekwencja praktyczna: brak niezmienniczości na przesunięcie. W sieci gęstej każda waga jest przypisana do jednego, konkretnego miejsca obrazu. Waga, która wyuczyła się „tu przy górnej krawędzi zaczyna się kreska siódemki", jest bezużyteczna, gdy ta sama kreska pojawi się dwa piksele niżej. Nasza sieć z Jednostki 10.3 radziła sobie tylko dlatego, że MNIST jest zbiorem wypreparowanym: cyfry są wyśrodkowane i wyskalowane. Na fotografiach nic nie jest wyśrodkowane.
📐 DEFINICJA — niezmienniczość na przesunięcie: własność metody rozpoznawania, dzięki której ten sam wzorzec zostaje rozpoznany niezależnie od tego, w którym miejscu obrazu się znajduje.
Po ludzku: kot w lewym górnym rogu i kot na środku to dla modelu ten sam kot.
💭 Pomyśl
Mamy sieć gęstą, wytrenowaną na wyśrodkowanych cyfrach MNIST, która osiąga 98% trafności. Bierzemy zbiór testowy i przesuwamy w nim każdą cyfrę o cztery piksele w prawo — nic więcej. Dla człowieka zmiana jest niewidoczna. Dlaczego trafność sieci może wyraźnie spaść, choć „to przecież te same obrazki"? I dlaczego augmentacja danych (Jednostka 11.5) jest tu tylko łataniem objawu?
Sprawdź odpowiedź
Bo dla sieci gęstej wejście to wektor 784 liczb, a każda waga jest przywiązana do jednej pozycji w tym wektorze. Po przesunięciu cyfry niezerowe jasności pojawiają się na zupełnie innych wejściach — obsługiwanych przez wagi, które nigdy nie widziały kreski i nie mają pojęcia, co z nią zrobić. Sieć nie ma żadnego mechanizmu mówiącego „piksel 100 i piksel 104 są sąsiadami", więc nie potrafi przenieść tego, czego się nauczyła, w inne miejsce obrazu.
Augmentacja (dorzucanie do treningu tych samych obrazków przesuniętych, obróconych, lekko przeskalowanych) faktycznie pomaga: sieć uczy się wtedy rozpoznawać kreskę osobno w wielu położeniach. Ale to jest kupowanie niezmienniczości za dane i parametry — sieć musi wielokrotnie, redundantnie wyuczyć się tego samego wzorca w różnych miejscach. Sieć konwolucyjna rozwiązuje to strukturalnie: ma jeden zestaw wag przesuwany po całym obrazie, więc wzorzec wyuczony raz działa wszędzie. Zamiast uczyć model, że położenie nie ma znaczenia, wpisujemy tę wiedzę w architekturę.
⚠️ Uwaga, pułapka
Nie myl liczby pikseli z liczbą parametrów. Rozdzielczość opisuje dane, parametry opisują model; rosną zależnie, ale to dwie różne rzeczy.
I nie zakładaj, że „więcej pikseli = lepszy model". Podwojenie rozdzielczości w obu wymiarach czterokrotnie zwiększa liczbę wejść i koszt obliczeń, a zwykle nie wnosi informacji istotnej dla zadania — dlatego typowe sieci pracują na obrazach zmniejszonych do 224 × 224 albo 384 × 384, nawet jeśli oryginał ma 12 megapikseli. Odwrotnie bywa w medycynie: w histopatologii szczegół rozstrzyga o diagnozie, więc preparat cyfrowy analizuje się w oryginalnym powiększeniu, kawałek po kawałku (Jednostka 12.5). Rozdzielczość dobiera się do zadania, nie „na maksa".
🌍 Powiązania
Zamiana obrazu na tablicę liczb jest pierwszym krokiem każdego zastosowania widzenia maszynowego — i ten sam chwyt zobaczysz przy języku, gdzie słowo stanie się wektorem liczb (Jednostka 14.3). W Jednostce 12.2 zobaczysz, jak konwolucja rozwiązuje oba problemy z tej jednostki jednym ruchem: redukuje liczbę wag o kilka rzędów wielkości i wpisuje sąsiedztwo pikseli w architekturę.
📐 Definicje tej lekcji
- Piksel — najmniejszy element obrazu; jedna liczba (0–255) w skali szarości, trzy liczby w RGB.
- Kanał — jedna z warstw liczb opisujących obraz; szarość ma 1 kanał, kolor 3 (R, G, B).
- Rozdzielczość — liczba pikseli obrazu, wysokość × szerokość.
- Niezmienniczość na przesunięcie — rozpoznanie wzorca niezależnie od jego położenia w obrazie.
📌 Najważniejsze w pigułce
- Do sieci nie wchodzi obraz, tylko tablica liczb: wysokość × szerokość × liczba kanałów.
- Skala szarości = 1 kanał (0–255), kolor = 3 kanały RGB. Zdjęcie z telefonu to ~36 milionów liczb.
- Sieć gęsta na zdjęciu 224 × 224 × 3 potrzebowałaby ponad 150 milionów wag w jednej warstwie — kosztem pamięci, czasu i przeuczenia.
- Poważniejszy problem: sieć gęsta nie wie, które piksele są sąsiadami (można je przetasować bez straty) i nie jest niezmiennicza na przesunięcie.
- MNIST działał na sieci gęstej, bo jest wypreparowany: cyfry wyśrodkowane i wyskalowane. Fotografie takie nie są.
- Rozdzielczość dobiera się do zadania — więcej pikseli to czterokrotnie większy koszt, nie automatycznie lepszy wynik.
🎒 Zadania
Zadanie 12.1.1. Obrazek ma 96 × 96 pikseli. Policz, ile liczb wchodzi do sieci, jeśli jest (a) w skali szarości, (b) kolorowy. Następnie policz liczbę wag (bez obciążeń) pierwszej warstwy gęstej o 256 neuronach w wariancie (b).
Pokaż rozwiązanie
(a) 96 · 96 · 1 = 9216 liczb. (b) 96 · 96 · 3 = 27 648 liczb.
Warstwa gęsta o 256 neuronach na wejściu 27 648: 27 648 · 256 = 7 077 888 wag (plus 256 obciążeń). Ponad siedem milionów parametrów na jedną warstwę i na obrazek mniejszy od miniatury — a to jeszcze nie zdjęcie, tylko kwadracik 96 × 96.
Zadanie 12.1.2. Wyjaśnij, co dokładnie pokazuje eksperyment z przetasowaniem pikseli (ten sam sposób tasowania we wszystkich obrazkach) i dlaczego jest to argument przeciw sieci gęstej na obrazach, a nie przeciw sieciom w ogóle.
Pokaż rozwiązanie
Eksperyment pokazuje, że sieć gęsta traktuje wejście jako nieuporządkowany worek liczb: skoro po konsekwentnym przetasowaniu pikseli uczy się równie dobrze, to znaczy, że nigdy nie korzystała z informacji o tym, które piksele leżą obok siebie. Tymczasem w obrazie ta informacja jest kluczowa — krawędź, tekstura czy kształt to zawsze układ sąsiadujących pikseli.
To argument przeciw tej architekturze przy tych danych, nie przeciw sieciom jako takim: problem polega na niedopasowaniu założeń architektury do struktury danych. Rozwiązaniem jest architektura, która sąsiedztwo ma wpisane w konstrukcję (splot dla obrazów, a później mechanizmy uwagi dla tekstu — Dział 15). Zauważ przy okazji, że dla danych naprawdę bezstrukturalnych (np. tabela z kilkudziesięcioma niezależnymi cechami pacjenta) sieć gęsta jest właściwym wyborem.
Zadanie 12.1.3. Aparat robi zdjęcia 4000 × 3000. Przed podaniem do sieci zmniejszamy je do 224 × 224. Policz, ile razy zmalała liczba wejść. Podaj jedno zadanie, w którym takie zmniejszenie jest bezpieczne, i jedno, w którym byłoby błędem.
Pokaż rozwiązanie
Wejść było 4000 · 3000 · 3 = 36 000 000, zostaje 224 · 224 · 3 = 150 528. Iloraz: 36 000 000 / 150 528 ≈ 239 razy mniej.
Bezpieczne: „czy na zdjęciu jest pies czy kot" — kształt zwierzęcia i jego proporcje są w pełni czytelne w małej rozdzielczości, a szczegóły sierści nie wnoszą nic do decyzji. Błąd: wykrywanie mikrozwapnień w mammografii albo ocena pojedynczych komórek w preparacie histopatologicznym — tam rozstrzygające struktury mają kilka pikseli i po zmniejszeniu przestają istnieć. W takich zadaniach analizuje się obraz w oryginalnym powiększeniu, we fragmentach (Jednostka 12.5).
🔍 Sprawdź, czy umiesz
- [ ] Opisać obraz cyfrowy jako tablicę liczb (piksele, skala szarości, kanały RGB).
- [ ] Policzyć liczbę wejść i wag pierwszej warstwy gęstej dla podanej rozdzielczości.
- [ ] Wyjaśnić eksperyment z przetasowaniem pikseli i jego wniosek.
- [ ] Wyjaśnić, czym jest niezmienniczość na przesunięcie i dlaczego sieć gęsta jej nie ma.