Pooling i architektura sieci konwolucyjnej
🎯 Po co Ci to?
Zauważ, co się właśnie stało: obrazek miał 784 liczby, a po jednej warstwie splotowej mamy ich 21 632. Konwolucja danych nie zmniejszyła — powiększyła je trzydziestokrotnie. Gdybyśmy tak układali warstwę na warstwie, sieć utonęłaby we własnych mapach cech.
Dlatego CNN ma drugą operację, prostą do banału i niezwykle skuteczną: pooling, czyli regularne zmniejszanie map cech. Po niej złożymy całą sieć od wejścia do softmaxu i policzymy jej parametry — wszystkie sto cztery tysiące, do sprawdzenia na kalkulatorze. To będzie pierwsza kompletna, realna architektura w tym podręczniku.
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- wyjaśnić max pooling: okno 2 × 2, brak zazębiania, zero parametrów;
- policzyć wymiar map cech po poolingu;
- opisać typową architekturę CNN: naprzemiennie splot i pooling, spłaszczenie, warstwa gęsta, softmax;
- odczytać tabelę warstw i samodzielnie zweryfikować liczbę parametrów;
- wyjaśnić, co pooling zyskuje (tolerancja na drobne przesunięcia, tańsze obliczenia), a co traci (dokładne położenie).
🔁 Przypomnij sobie
Z Jednostki 12.2 wiesz, że warstwa splotowa z 32 filtrami daje 32 mapy cech 26 × 26, a filtr zawsze sięga przez wszystkie kanały wejścia. Z Jednostki 10.3 wiesz, jak wygląda koniec sieci klasyfikującej: warstwa wyjściowa z softmaxem zamieniająca surowe liczby na dziesięć pewności sumujących się do jedynki. Z Jednostki 11.4 pamiętasz różnicę między parametrem (uczy się go sieć) i hiperparametrem (ustawia go człowiek) — ta różnica zaraz się przyda.
📘 Max pooling: zostaw najmocniejszą odpowiedź
Pooling działa tak: dzielimy mapę cech na małe okna — najczęściej 2 × 2 — i z każdego okna zostawiamy jedną liczbę. W wariancie najpopularniejszym, max poolingu, zostawiamy tę największą, czyli najjaśniejszy punkt (przypomnijmy: 255 to biel, 0 to czerń). Okna nie zazębiają się: po oknie 2 × 2 przesuwamy się o dwa piksele, nie o jeden.
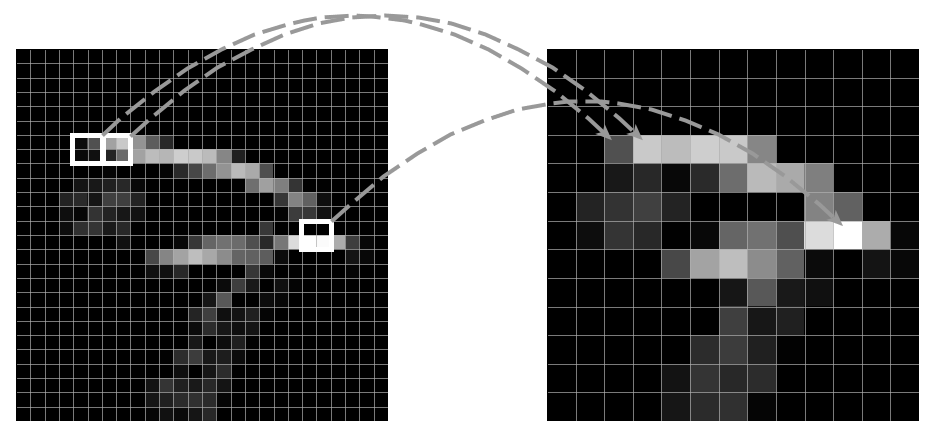
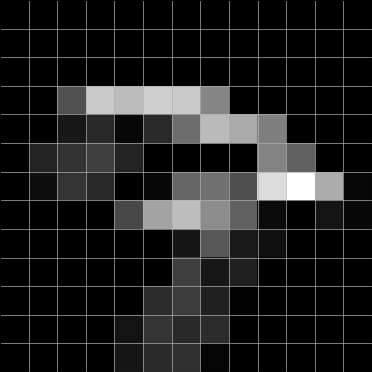
Efekt jest arytmetycznie oczywisty: z okna 2 × 2 robi się 1 × 1, więc mapa cech maleje dwukrotnie w każdym wymiarze, a liczba wartości czterokrotnie. Mapa 26 × 26 staje się 13 × 13.
I teraz rzecz, którą warto zauważyć osobno: pooling nie ma ani jednego parametru. Nie ma tu czego uczyć — „weź największą z czterech liczb" jest ustaloną regułą, nie wagą do korekty. Wielkość okna to hiperparametr (Jednostka 11.4), ustawia go człowiek przed treningiem.
Co pooling zachowuje, a co wyrzuca? Zachowuje informację „czy ta cecha tu wystąpiła i jak mocno". Wyrzuca informację „gdzie dokładnie w obrębie tego okna". To wymiana bardzo opłacalna, bo daje dwie rzeczy naraz. Pierwsza: tolerancja na drobne przesunięcia — przesunięcie kreski o jeden piksel często nie zmienia maksimum w oknie, więc odpowiedź sieci zostaje ta sama. Druga, ważniejsza, choć mniej oczywista: po zmniejszeniu mapy filtr 3 × 3 w następnej warstwie obejmuje większy kawałek oryginalnego obrazu. To zalążek hierarchii cech, do którego wrócimy w Jednostce 12.4.
📐 DEFINICJA — pooling (analiza puli pikseli): operacja zmniejszająca mapę cech przez zastąpienie każdego okna (np. 2 × 2) jedną liczbą, obliczoną z tego okna. Nie ma parametrów.
Po ludzku: zgrubne pomniejszenie mapy odpowiedzi, w którym zostawiamy to, co najmocniejsze.
📐 DEFINICJA — max pooling: wariant poolingu zostawiający z każdego okna wartość największą.
Czym to NIE jest: to nie kompresja obrazu — pooling nie służy do odtworzenia oryginału, a wyrzuconej informacji o dokładnym położeniu nie da się odzyskać.
Dla porządku: istnieje też średni pooling (średnia z okna, dziś rzadszy w środku sieci) oraz globalny średni pooling — jedna liczba z całej mapy cech, popularna bezpośrednio przed warstwą wyjściową. W nowszych architekturach pooling bywa też zastępowany splotem z krokiem 2, który robi to samo zmniejszenie, tylko za pomocą wag, których sieć się uczy.
📘 Cała sieć, warstwa po warstwie
Mamy oba klocki. Poniżej realna architektura CNN rozpoznającej cyfry MNIST — z wymiarami i liczbą parametrów każdej warstwy:
| Warstwa | Wymiar wyjścia | Parametry |
|---|---|---|
| wejście (obrazek w skali szarości) | 28 × 28 × 1 | 0 |
| splot 1 — 32 filtry 3 × 3 | 26 × 26 × 32 | 320 |
| max pooling 1 — okno 2 × 2 | 13 × 13 × 32 | 0 |
| splot 2 — 64 filtry 3 × 3 | 11 × 11 × 64 | 18 496 |
| max pooling 2 — okno 2 × 2 | 5 × 5 × 64 | 0 |
| splot 3 — 128 filtrów 3 × 3 | 3 × 3 × 128 | 73 856 |
| spłaszczenie | 1152 | 0 |
| warstwa gęsta + softmax — 10 klas | 10 | 11 530 |
| razem | 104 202 |
Przejdźmy to rachunkowo, bo każda liczba w tej tabeli daje się sprawdzić:
- Splot 1: wejście ma 1 kanał, więc filtr to 3 · 3 · 1 + 1 = 10 parametrów; 32 filtry → 320. Wymiar: 28 − 3 + 1 = 26.
- Pooling 1: 26 / 2 = 13. Zero parametrów.
- Splot 2: wejście ma teraz 32 kanały, więc jeden filtr to 3 · 3 · 32 + 1 = 289 parametrów; 64 filtry → 289 · 64 = 18 496. Wymiar: 13 − 3 + 1 = 11.
- Pooling 2: 11 / 2 = 5,5 → 5. Przy nieparzystym wymiarze niepełne okno na brzegu jest po prostu pomijane.
- Splot 3: wejście ma 64 kanały: 3 · 3 · 64 + 1 = 577; 128 filtrów → 577 · 128 = 73 856. Wymiar: 5 − 3 + 1 = 3.
- Spłaszczenie: 128 map po 3 · 3 = 9 wartości daje jeden długi wektor: 3 · 3 · 128 = 1152 liczby. Zero parametrów — to tylko przepisanie tych samych liczb w rządek.
- Warstwa gęsta z softmaxem: 1152 wejścia razy 10 neuronów plus 10 obciążeń = 11 530. Na wyjściu dziesięć pewności, po jednej na cyfrę (Jednostka 10.3).
Suma: 320 + 18 496 + 73 856 + 11 530 = 104 202 parametry. Cała sieć — mniej niż jedna tysięczna tego, co pochłonęłaby jedna warstwa gęsta na zdjęciu 224 × 224.
Trzy obserwacje, które warto z tej tabeli wynieść.
Pierwsza: kanałów coraz więcej, rozdzielczości coraz mniej. 32 → 64 → 128 map cech, przy wymiarach 26 → 13 → 11 → 5 → 3. Sieć systematycznie wymienia informację „gdzie" na informację „co": im głębiej, tym mniej wie o dokładnym położeniu, a więcej o tym, jakie wzorce są obecne.
Druga: parametry są skupione na końcu. Pierwsza warstwa splotowa to 320 parametrów — 0,3% całości. Grubo ponad dwie trzecie siedzi w splotach 2 i 3, bo tam każdy filtr sięga przez dziesiątki kanałów. Intuicja „pierwsza warstwa jest najdroższa, bo obraz jest największy" jest myląca: koszt obliczeń faktycznie jest z przodu, ale koszt parametrów — z tyłu.
Trzecia: mapy cech przestają wyglądać jak cyfra. Po pierwszym poolingu siódemkę jeszcze widać; w drugiej warstwie splotowej mapy są już małymi, abstrakcyjnymi plamami:
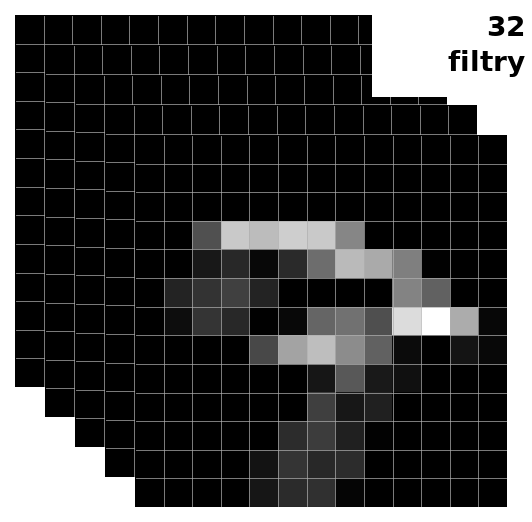
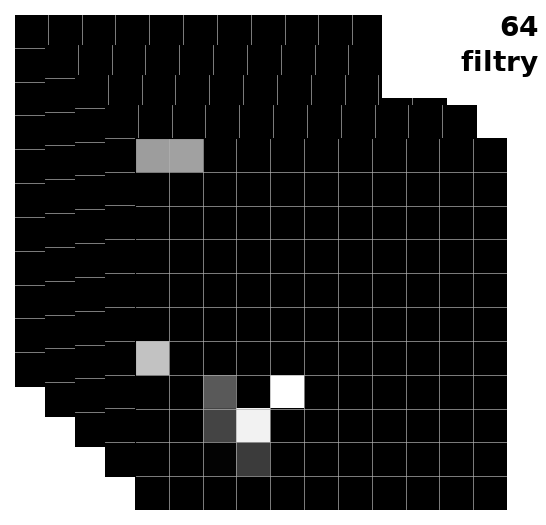
To nie usterka. Głębsze mapy nie opisują już wyglądu cyfry, tylko obecność cech — a te nie muszą przypominać niczego, co człowiek umie nazwać. Wracamy tu do reprezentacji z Jednostki 10.4: sieć przekłada dane na własny język, w którym końcowe rozstrzygnięcie staje się łatwe.
💭 Pomyśl
Warstwa poolingu nie ma ani jednego parametru — sieć niczego się w niej nie uczy. Skoro tak, po co ona w sieci? Czy nie prościej byłoby ją wyrzucić i ułożyć splot za splotem?
Sprawdź odpowiedź
Można ułożyć splot za splotem — takie sieci istnieją — ale trzeba wtedy jakoś zastąpić trzy rzeczy, które pooling załatwia za darmo.
Pierwsza: koszt. Bez zmniejszania mapy zostają duże, a każda kolejna warstwa liczy się na wszystkich ich pikselach. Pooling 2 × 2 ścina liczbę wartości czterokrotnie na każdym poziomie — i to on sprawia, że sieć o kilkunastu warstwach jest w ogóle obliczalna.
Druga, najważniejsza: pole widzenia. Filtr 3 × 3 zawsze widzi tylko 3 × 3 sąsiadujące elementy swojego wejścia. Jeśli wejście nigdy się nie zmniejsza, to nawet w dziesiątej warstwie filtr obejmuje wciąż drobny kawałek obrazu — i sieć nie ma jak zapytać o coś dużego („czy to jest twarz?"). Pooling zmniejsza mapę, więc te same 3 × 3 obejmują dwa razy większy fragment oryginału. Bez zmniejszania nie ma hierarchii cech (Jednostka 12.4).
Trzecia: tolerancja na drobne przesunięcia. Maksimum z okna nie zmienia się, gdy cecha przesunie się o piksel.
Pooling jest więc czymś rzadkim: elementem architektury, który nic nie kosztuje w parametrach, a robi bardzo wiele. Alternatywą stosowaną w nowszych sieciach jest splot z krokiem 2 — daje to samo zmniejszenie, ale za cenę parametrów, w zamian pozwalając sieci nauczyć się, jak zmniejszać.
⚠️ Uwaga, pułapka
Pooling to nie kompresja obrazu. Kompresja (jak JPEG) ma na celu odtworzenie czegoś podobnego do oryginału; pooling nie ma takiego celu i nie da się z niego wrócić. Wyrzuca dokładne położenie — świadomie i bezpowrotnie.
To ma poważną konsekwencję praktyczną: sieć zbudowana z naprzemiennych splotów i poolingów jest dobra w odpowiedzi na pytanie „czy na obrazie jest X", a zła w pytaniu „gdzie dokładnie, z dokładnością do piksela, jest X". Zadania wymagające precyzyjnej lokalizacji — wykrywanie obiektów z ramkami, segmentacja (który piksel należy do guza) — używają architektur, które zgubioną rozdzielczość odzyskują dodatkowymi mechanizmami. Sam stos splot–pooling tego nie zrobi.
🌍 Powiązania
Architekturę z tej jednostki rozpoznasz w LeNet-5 z 1998 roku i w AlexNecie z 2012 (Jednostka 13.2) — różnią się liczbą warstw i rozmiarem, nie pomysłem. Zmniejszanie map cech jest też mechaniczną przyczyną hierarchii „krawędzie → części → obiekty" (Jednostka 12.4), a to, że głębsze mapy przestają przypominać obraz, jest tym samym zjawiskiem, które w Jednostce 10.4 nazwaliśmy reprezentacją.
📐 Definicje tej lekcji
- Pooling — zmniejszenie mapy cech przez zastąpienie okna jedną liczbą; bez parametrów.
- Max pooling — pooling zostawiający z okna wartość największą; okna nie zazębiają się.
- Średni / globalny średni pooling — warianty ze średnią z okna / ze średnią z całej mapy cech.
- Spłaszczenie — przepisanie wszystkich map cech w jeden długi wektor przed warstwą gęstą.
- Architektura CNN — naprzemienne sploty i poolingi, na końcu spłaszczenie i warstwa gęsta z softmaxem.
📌 Najważniejsze w pigułce
- Konwolucja powiększa dane (784 → 21 632 liczby); pooling je zmniejsza — dlatego występują naprzemiennie.
- Max pooling z oknem 2 × 2 zostawia największą wartość z każdego okna: wymiar spada dwukrotnie, liczba wartości czterokrotnie.
- Pooling nie ma parametrów — rozmiar okna to hiperparametr.
- Pooling zachowuje „czy cecha wystąpiła", wyrzuca „gdzie dokładnie" — stąd tolerancja na drobne przesunięcia i większe pole widzenia kolejnych filtrów.
- Typowa CNN: splot → pooling → splot → pooling → splot → spłaszczenie → warstwa gęsta + softmax.
- W przykładowej sieci MNIST: 104 202 parametry — każdą liczbę w tabeli warstw można sprawdzić rachunkiem.
- Reguła architektury: kanałów coraz więcej, rozdzielczości coraz mniej — wymiana „gdzie" na „co".
- Głębsze mapy cech nie wyglądają już jak obrazek i nie powinny: opisują obecność cech, nie wygląd.
- Sam stos splot–pooling odpowiada na „czy jest X", nie na „gdzie dokładnie jest X".
🎒 Zadania
Zadanie 12.3.1. Wejście to obraz 64 × 64 w skali szarości. Sieć ma: splot 32 filtry 3 × 3 (krok 1, bez uzupełniania), max pooling 2 × 2, splot 64 filtry 3 × 3, max pooling 2 × 2. Podaj wymiar wyjścia po każdej z tych czterech warstw oraz liczbę parametrów obu splotów.
Pokaż rozwiązanie
- splot 1: 64 − 3 + 1 = 62 → 62 × 62 × 32; parametry: (3 · 3 · 1 + 1) · 32 = 320
- pooling 1: 62 / 2 = 31 → 31 × 31 × 32; 0 parametrów
- splot 2: 31 − 3 + 1 = 29 → 29 × 29 × 64; parametry: (3 · 3 · 32 + 1) · 64 = 289 · 64 = 18 496
- pooling 2: 29 / 2 = 14,5 → 14 × 14 × 64 (niepełne okno na brzegu pomijamy); 0 parametrów
Razem sploty: 18 816 parametrów.
Zadanie 12.3.2. W tabeli architektury MNIST warstwa gęsta ma 11 530 parametrów, a splot 3 aż 73 856 — choć warstwa gęsta „widzi" 1152 liczby, a splot tylko 3 × 3. Wyjaśnij tę różnicę i policz, ile parametrów miałaby warstwa gęsta o 128 neuronach wstawiona między spłaszczenie a wyjście.
Pokaż rozwiązanie
Różnica bierze się z tego, że filtr sięga przez wszystkie kanały wejścia. Splot 3 dostaje 64 mapy cech, więc jeden filtr „3 × 3" ma w rzeczywistości 3 · 3 · 64 = 576 wag, a takich filtrów jest 128 — stąd 577 · 128 = 73 856. Warstwa gęsta ma tylko 10 neuronów, więc mimo 1152 wejść wychodzi 1152 · 10 + 10 = 11 530. Liczba parametrów zależy od iloczynu rozmiaru wejścia i liczby jednostek, nie od samego rozmiaru okna.
Warstwa gęsta o 128 neuronach między spłaszczeniem a wyjściem: 1152 · 128 + 128 = 147 584 parametry, a warstwa wyjściowa zmalałaby do 128 · 10 + 10 = 1290. Cała sieć: 320 + 18 496 + 73 856 + 147 584 + 1290 = 241 546 — czyli ponad dwa razy więcej niż wcześniej, i to z jednej dodanej warstwy gęstej. Dokładnie dlatego nowoczesne architektury trzymają część gęstą tak małą, jak się da.
Zadanie 12.3.3. Wyjaśnij, dlaczego w typowej CNN liczba kanałów rośnie (32 → 64 → 128), podczas gdy wymiary map cech maleją (26 → 13 → 11 → 5 → 3). Co byłoby złego w architekturze, która utrzymuje 32 kanały do końca?
Pokaż rozwiązanie
Bo im głębiej, tym więcej różnych rzeczy trzeba móc rozpoznać, a jednocześnie tym mniej istotne jest dokładne położenie. Pierwsza warstwa potrzebuje niewielu filtrów, bo lokalnych wzorców na poziomie pikseli jest garść (krawędzie o różnych nachyleniach, kontrasty, plamy). Głębiej pytania są bogatsze: „narożnik", „łuk", „fragment pętli cyfry", „końcówka kreski" — takich układów jest znacznie więcej, więc trzeba więcej kanałów. Równolegle wymiary spadają, bo od pewnego momentu nie interesuje nas „w którym pikselu", lecz „czy w tym rejonie". Sieć zamienia rozdzielczość przestrzenną na bogactwo opisu.
Architektura z 32 kanałami do końca miałaby zbyt wąskie gardło: na najgłębszym poziomie mogłaby wyrazić najwyżej 32 rodzaje złożonych cech dla całego obrazu. Przy dziesięciu cyfrach może to jeszcze wystarczy; przy tysiącu klas ImageNetu — na pewno nie. Odwrotna skrajność (utrzymywać wysoką rozdzielczość i dużo kanałów) jest poprawna merytorycznie, ale nieobliczalna: liczba wartości i kosztów obliczeń rośnie wtedy iloczynowo na każdym poziomie.
🔍 Sprawdź, czy umiesz
- [ ] Wyjaśnić max pooling i policzyć wymiar mapy cech po poolingu (także dla wymiaru nieparzystego).
- [ ] Powiedzieć, ile parametrów ma warstwa poolingu — i dlaczego.
- [ ] Opisać typową architekturę CNN od wejścia do softmaxu.
- [ ] Zweryfikować rachunkiem liczbę parametrów dowolnej warstwy z tabeli.
- [ ] Wyjaśnić regułę „więcej kanałów, mniejsza rozdzielczość" i co pooling nieodwracalnie traci.