Jak działa CNN: od krawędzi do obiektu
🎯 Po co Ci to?
Umiesz już złożyć sieć konwolucyjną i policzyć jej parametry. Zostało pytanie ciekawsze: dlaczego to działa? I drugie, bardziej konkretne: w Jednostce 10.4 poznałeś hierarchię reprezentacji — krawędzie, potem narożniki, potem części obiektów, na końcu obiekty. Powiedzieliśmy wtedy, że wynika ona z ułożenia warstw jedna za drugą. W sieci konwolucyjnej ma jednak drugą, bardziej mechaniczną przyczynę, którą da się wskazać palcem: rosnące pole widzenia jednego filtra.
Przy okazji poznasz historię, która jest jednym z najlepszych przykładów tezy przewijającej się przez cały ten podręcznik: dobry pomysł bez warunków jest bezsilny. Sieć konwolucyjna działała już w 1998 roku — i na czternaście lat przepadła.
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- wyjaśnić, dlaczego CNN analizuje obraz lokalnie, i użyć analogii dużego płótna;
- opisać filtry jako „oczy" sieci i uzasadnić, dlaczego sieć sama ustawia swoje oczy;
- wyjaśnić pojęcie pola recepcyjnego i pokazać, jak z niego wynika hierarchia cech;
- opowiedzieć historię CNN: Fukushima (1980), LeCun (1989), LeNet-5 (1998) i czternastoletnia przerwa;
- powiedzieć uczciwie, czego metafora „sieć widzi" nie oddaje.
🔁 Przypomnij sobie
Z Jednostki 10.4 wiesz o hierarchii reprezentacji i o tym, że nikt jej nie zaprogramował — a także o Hublu i Wieselu, o wieloznaczności neuronów i o tym, że wszystkie opisy „na co reaguje neuron" są rekonstrukcjami po fakcie. Z Jednostki 12.2 wiesz, że wagi filtrów są zwykłymi parametrami, uczonymi propagacją wsteczną (Jednostka 11.3). Z Jednostki 12.3 wiesz, że pooling zmniejsza mapy cech dwukrotnie na każdym poziomie. Te trzy rzeczy złożą się teraz w jedno wyjaśnienie.
📘 Lokalnie, nie całościowo
Sieć gęsta „patrzyła" na obraz całościowo: każdy neuron pierwszej warstwy dostawał naraz wszystkie piksele. Trochę jak my, gdy stajemy w odpowiedniej odległości od dużego płótna — na przykład „Bitwy pod Grunwaldem" Jana Matejki o wymiarach około 4 na 10 metrów — żeby ogarnąć całą scenę.
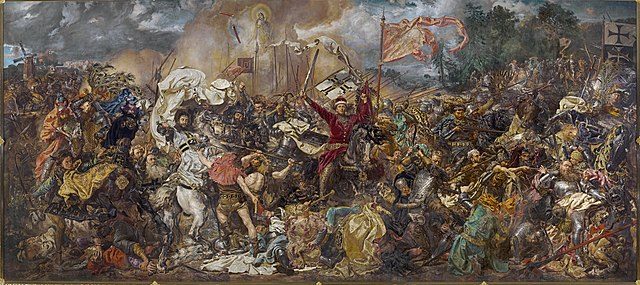
Tylko że z tego dystansu nie widzimy nic poza kompozycją. Żeby zobaczyć twarz Witolda, ostrze kopii albo minę konia, musimy podejść blisko i oglądać obraz fragment po fragmencie. Dokładnie tak pracuje sieć konwolucyjna: nie patrzy na całość, lecz przesuwa po obrazie okienko 3 × 3 (albo 5 × 5) i w każdym miejscu zadaje to samo lokalne pytanie. Jej odpowiedź na problem wielkości obrazu nie brzmi „obejmij wszystko naraz", ale „obejdź systematycznie każdy fragment".
📘 Filtry jako „oczy" sieci — które sieć ustawia sobie sama
Każdy filtr można traktować jako jedno wyspecjalizowane oko, wyczulone na jeden aspekt obrazu: kierunek linii, kształt, kontrast, teksturę. Warstwa z 32 filtrami to 32 pary oczu patrzące na to samo płótno i wypatrujące czegoś innego; cała sieć ma ich setki, rozłożone na poziomach coraz większej abstrakcji.
Kluczowe jest to, co powiedzieliśmy w pułapce Jednostki 12.2: sieć ustawia swoje oczy sama. Wartości wag w filtrach nie są projektem człowieka, tylko wynikiem treningu — a to znaczy, że zależą od zadania. Sieć ucząca się odróżniać zwykły pieprzyk od czerniaka wypracuje inne filtry niż sieć wykrywająca retinopatię cukrzycową na zdjęciu dna oka, mimo identycznej architektury. Nie dostały różnych instrukcji; dostały różne dane i tę samą funkcję straty do zminimalizowania (Jednostka 11.1).
📘 Skąd bierze się hierarchia: rosnące pole recepcyjne
Teraz sedno tej jednostki. Filtr 3 × 3 w pierwszej warstwie widzi dokładnie 3 × 3 piksele oryginału — więc najbardziej użyteczne, o co może zapytać, to lokalna różnica jasności, czyli krawędź. Nic większego nie jest dla niego dostępne.
Ale po poolingu każdy „piksel" mapy cech odpowiada już obszarowi 2 × 2 oryginału. Filtr 3 × 3 w drugiej warstwie, patrząc na dziewięć takich pikseli, obejmuje więc co najmniej 6 × 6 pikseli oryginalnego obrazu (a licząc dokładnie, wraz z zazębianiem się okien pierwszego splotu — 8 × 8). Po kolejnym poolingu ten sam filtr 3 × 3 obejmuje kilkanaście pikseli oryginału, jeszcze głębiej — kilkadziesiąt, aż w końcu praktycznie cały obraz.
Ten fragment oryginalnego obrazu, który wpływa na jedną liczbę w danej warstwie, nazywa się polem recepcyjnym tego neuronu.
  warstwa 1   filtr 3×3  →  pole recepcyjne ~3×3 px    „krawędź, plama"
     pooling ↓2
  warstwa 2   filtr 3×3  →  pole recepcyjne ~8×8 px    „narożnik, łuk"
     pooling ↓2
  warstwa 3   filtr 3×3  →  pole recepcyjne ~20×20 px  „część obiektu"
     pooling ↓2
  warstwa n   filtr 3×3  →  pole ≈ cały obraz          „obiekt"
I tu domyka się wyjaśnienie z Jednostki 10.4. Hierarchia cech nie jest pomysłem projektanta ani szczęśliwym przypadkiem — jest wymuszona dwoma faktami naraz. Po pierwsze, warstwa może korzystać wyłącznie z tego, co dostała od poprzedniej (to znaliśmy). Po drugie, w sieci splotowej im głębiej, tym większy kawałek oryginału widzi jeden neuron — więc głębokie warstwy po prostu nie mają jak pytać o piksele, a płytkie nie mają jak pytać o twarze. Pytanie „czy to jest twarz?" można postawić tylko tam, gdzie pole recepcyjne obejmuje twarz.
📐 DEFINICJA — pole recepcyjne: obszar oryginalnych danych wejściowych, który wpływa na wartość jednej liczby w danej warstwie sieci. Rośnie z głębokością — tym szybciej, im częściej stosuje się pooling lub krok większy niż 1.
Po ludzku: „ile obrazu widzi" jeden neuron danej warstwy.
To tłumaczy też obserwację z Jednostki 12.3, że głębsze mapy cech przestają przypominać cyfrę. Nie dlatego, że sieć ją gubi. Dlatego, że przestaje opisywać wygląd fragmentów, a zaczyna opisywać obecność coraz bardziej złożonych cech w coraz większych obszarach.
📘 Historia: pomysł, który wyprzedził swoje warunki
Sieć konwolucyjna jest starsza, niż większość ludzi sądzi.
1980 — Kunihiko Fukushima publikuje Neocognitron: architekturę z warstwami lokalnych detektorów przeplatanymi warstwami „usredniającymi" (dzisiejszy pooling), jawnie inspirowaną badaniami kory wzrokowej Hubla i Wiesela (Jednostka 10.4). Wszystkie klocki są na miejscu. Brakuje jednego: skutecznej metody uczenia — Neocognitron nie był trenowany propagacją wsteczną.
1989 — Yann LeCun w Bell Labs łączy architekturę splotową z propagacją wsteczną (Jednostka 11.3) i pokazuje, że taka sieć uczy się rozpoznawać ręcznie pisane cyfry. To moment narodzin CNN w dzisiejszym sensie: filtry nie są projektowane, są uczone.
1998 — LeNet-5, dopracowana wersja tej architektury, działa komercyjnie: odczytuje ręcznie pisane kwoty na czekach bankowych w Stanach Zjednoczonych, obsługując znaczną część tego strumienia. To nie demonstracja laboratoryjna — to system produkcyjny w rękach banków.
A potem — czternaście lat ciszy. Sieci splotowe pozostają niszą, a rozpoznawaniem obrazów rządzą metody z ręcznie projektowanymi cechami (Jednostka 9.2). Dlaczego, jeśli pomysł już działał?
Bo brakowało warunków, a nie idei. Brakowało danych w skali milionów oznaczonych obrazów — ImageNet powstanie w 2009 (Jednostka 13.2). Brakowało moci obliczeniowej — treningi na procesorach trwały tygodniami, a karty graficzne wejdą do uczenia maszynowego około 2007–2010 (Jednostka 13.1). Brakowało technik treningu głębokich sieci: ReLU, dropoutu, dobrej inicjalizacji (Jednostka 11.5). Wszystkie trzy zbiegły się dopiero w 2012 roku — i wtedy sieć konwolucyjna, w istocie ta sama, którą LeCun opisał w 1989, wygrała ImageNet z przewagą, która zamknęła dyskusję (Jednostka 13.2).
📐 DEFINICJA — sieć konwolucyjna (CNN, sieć splotowa): architektura sieci neuronowej dla danych o strukturze przestrzennej (obrazy, dźwięk), zbudowana z naprzemiennych warstw splotowych i poolingu, w której ten sam filtr wag jest przesuwany po całych danych, wykrywając wzorzec niezależnie od położenia. Korzenie: Neocognitron (Fukushima, 1980); postać dzisiejsza: LeCun, 1989; LeNet-5, 1998.
Po ludzku: sieć, która ogląda obraz małym okienkiem, fragment po fragmencie, i buduje z tego coraz bardziej ogólne wnioski.
💭 Pomyśl
Dwie sieci o identycznej architekturze uczą się: pierwsza rozpoznawać czerniaka na zdjęciach skóry, druga — retinopatię cukrzycową na zdjęciach dna oka. Po treningu porównujemy ich wagi. Czego się spodziewasz w pierwszej warstwie splotowej — filtrów podobnych czy różnych? A w warstwach głębokich? Jaki praktyczny wniosek z tego wynika?
Sprawdź odpowiedź
W pierwszej warstwie filtry będą zaskakująco podobne: krawędzie o różnych nachyleniach, kontrasty, plamy barwne. Nie dlatego, że ktoś je uzgodnił, ale dlatego, że są to cechy użyteczne przy każdym obrazie — niezależnie od tego, czy szukamy czerniaka, litery czy kota. Pierwsza warstwa uczy się w istocie „języka obrazu w ogóle".
W warstwach głębokich filtry będą różne aż do nieporównywalności: jedna sieć składa cechy w „nieregularny brzeg zmiany barwnikowej", druga w „drobne wybroczyny i wysięki w okolicy plamki". Reguła: im głębiej, tym bardziej wyspecjalizowane pod zadanie i tym mniej przenośne.
Wniosek praktyczny to uczenie transferowe, o którym mówiliśmy w Jednostce 10.4: skoro wczesne warstwy są zadaniowo neutralne, można wziąć sieć wytrenowaną na milionach zwykłych zdjęć, zostawić jej wczesne filtry i douczyć tylko warstwy głębokie na kilku tysiącach obrazów medycznych. To dziś standardowy sposób pracy w medycynie obrazowej, gdzie zbiory rzadko liczą miliony przykładów. Uwaga na granicę tej sztuczki: przenosi się to, co wspólne wszystkim obrazom — a nie wiedza o chorobie.
⚠️ Uwaga, pułapka
Metafora „sieć widzi" jest wygodna i w trzech punktach nieprawdziwa.
Pierwszy: nie ma tu żadnego patrzenia. Jest ciąg mnożeń i sum, po którym zostaje wektor liczb. Nie ma spojrzenia, uwagi ani wrażenia — a już z pewnością nie ma rozumienia scen, o którym mowa w Dziale 19.
Drugi: nazwy w rodzaju „filtr wykrywający kreski poziome" albo „neuron reagujący na oczy" są odczytaniem po fakcie. Szukamy obrazków maksymalnie pobudzających dany filtr i nadajemy mu nazwę; sieć takich etykiet nie ma. Jak wiemy z Jednostki 10.4, pojedyncza jednostka bywa zresztą wieloznaczna i reaguje na dziwne mieszanki.
Trzeci, najważniejszy praktycznie: sieć nie wie, na co powinna patrzeć. Patrzy na to, co w jej danych treningowych statystycznie działa. Jeśli w zbiorze zdjęć skóry lekarze zwyczajowo obrysowywali markerem zmiany podejrzane, to obrys jest cechą świetnie predykcyjną — i sieć się jej nauczy, nie mając pojęcia, że popełnia błąd metodologiczny, a nie odkrycie. Tym tropem idziemy w Jednostce 12.5.
🌍 Powiązania
Ta jednostka domyka mechanicznie hierarchię z Jednostki 10.4 i przygotowuje dwie rzeczy. Pierwsza: rok 2012 i AlexNet (Jednostka 13.2) — zobaczysz tam dokładnie tę architekturę, tylko większą, oraz trzy warunki, których brakowało LeNetowi. Druga: granice widzenia maszynowego (Jednostka 12.5), które wynikają wprost z trzeciego punktu pułapki wyżej. Pole recepcyjne wróci też jako pojęcie kontrastowe przy transformatorach, gdzie mechanizm uwagi pozwala „widzieć" całe wejście od pierwszej warstwy (Dział 15).
📐 Definicje tej lekcji
- Pole recepcyjne — obszar oryginalnego wejścia wpływający na jedną liczbę w danej warstwie; rośnie z głębokością.
- Sieć konwolucyjna (CNN) — architektura naprzemiennych splotów i poolingu dla danych przestrzennych (Fukushima 1980; LeCun 1989; LeNet-5 1998).
- Neocognitron — architektura Fukushimy (1980) z lokalnymi detektorami i uśrednianiem, uczona bez propagacji wstecznej.
- LeNet-5 — sieć LeCuna (1998) odczytująca ręcznie pisane cyfry na czekach bankowych; pierwsze duże komercyjne zastosowanie CNN.
📌 Najważniejsze w pigułce
- CNN nie patrzy całościowo — obchodzi obraz małym okienkiem, fragment po fragmencie (analogia dużego płótna).
- Każdy filtr jest jak jedno wyspecjalizowane „oko"; warstwa ma ich dziesiątki, sieć — setki.
- Sieć sama ustawia swoje oczy: te same architektury na różnych zadaniach dają różne filtry.
- Pole recepcyjne rośnie z głębokością (pooling!), więc płytkie warstwy mogą pytać tylko o krawędzie, a głębokie — o obiekty.
- To druga, mechaniczna przyczyna hierarchii cech z Jednostki 10.4: nie tylko „co dostałem od poprzedniej warstwy", ale „jak duży kawałek oryginału widzę".
- Wczesne warstwy są przenośne między zadaniami, głębokie — nie. Stąd uczenie transferowe.
- CNN ma korzenie w 1980 (Neocognitron) i dojrzałą postać w 1989/1998 (LeCun, LeNet-5, czeki bankowe).
- Czternaście lat zwłoki wynikało z braku danych, mocy i technik treningu — nie z braku pomysłu.
- „Sieć widzi" to metafora: nie ma patrzenia, nazwy filtrów są nadawane po fakcie, a sieć nie wie, na co powinna patrzeć.
🎒 Zadania
Zadanie 12.4.1. Sieć ma kolejno: splot 3 × 3, pooling 2 × 2, splot 3 × 3, pooling 2 × 2, splot 3 × 3. Oszacuj (dolnym oszacowaniem, licząc każdy pooling jako podwojenie) pole recepcyjne neuronu w trzeciej warstwie splotowej. Powiedz, jakiego rodzaju cechy może wykrywać ta warstwa, a jakiego pierwsza.
Pokaż rozwiązanie
Szacowanie „w dół": splot 1 daje pole 3 × 3. Po poolingu każdy element odpowiada 2 pikselom, więc splot 2 obejmuje co najmniej 3 · 2 = 6, czyli 6 × 6. Po drugim poolingu skala rośnie znów dwukrotnie, więc splot 3 obejmuje co najmniej 6 · 2 = 12, czyli 12 × 12 pikseli oryginału. (Licząc dokładnie, z zazębianiem okien splotu, wychodzi więcej — ale rząd wielkości jest ten sam i on tu rozstrzyga.)
Pierwsza warstwa, widząc 3 × 3 piksele, może wykryć tylko cechy najprostsze: krawędź, kontrast, plamę. Trzecia, widząc obszar 12 × 12 (na obrazku 28 × 28 to blisko połowa szerokości!), może pytać o układy takich cech: pętlę cyfry, narożnik, końcówkę kreski. Nie chodzi o to, że projektant tak postanowił — trzecia warstwa nie ma dostępu do informacji o pojedynczym pikselu, a pierwsza nie ma dostępu do informacji o pętli.
Zadanie 12.4.2. LeNet-5 działała komercyjnie już w 1998 roku, a przełom w uczeniu głębokim nastąpił w 2012. Wskaż trzy brakujące warunki i przy każdym podaj jednostkę tego podręcznika, w której jest omówiony. Następnie odpowiedz: który z nich uważasz za najtrudniejszy do „przyspieszenia" i dlaczego?
Pokaż rozwiązanie
Trzy warunki: (1) dane w skali milionów oznaczonych obrazów — ImageNet, 2009 (Jednostka 13.2); (2) moc obliczeniowa, czyli karty graficzne i CUDA (Jednostka 13.1); (3) techniki treningu głębokich sieci: ReLU, dropout, dobra inicjalizacja, normalizacja (Jednostka 11.5).
Który najtrudniejszy do przyspieszenia? Uzasadnione są dwie odpowiedzi. Za danymi: nie da się ich wyprodukować samą pracą laboratorium — ImageNet wymagał istnienia internetu z milionami zdjęć oraz taniej pracy tłumu do ich oznaczania (Web 2.0, platformy crowdsourcingowe). To warunek społeczno-technologiczny, na który badacz nie ma wpływu. Za mocą: karty graficzne rozwinął rynek gier, a nie potrzeby AI — czyli był to czysty zbieg okoliczności, i to ten najbardziej „zewnętrzny" wobec dziedziny. Techniki treningu są w tym zestawie najbardziej „wewnętrzne": to praca badawcza, którą można było wykonać wcześniej — i częściowo wykonano, tylko bez danych i mocy nie było widać, że pomaga.
Zadanie 12.4.3. Oceń zdanie: „sieć konwolucyjna to zastosowanie w informatyce odkrycia Hubla i Wiesela o korze wzrokowej". Wskaż, co w tym zdaniu jest trafne, a co przesadzone. Skorzystaj z Jednostki 10.4.
Pokaż rozwiązanie
Trafne jest to, że zbieżność istnieje i nie jest przypadkowa w sensie inspiracji historycznej: Hubel i Wiesel opisali komórki reagujące na krawędzie o określonym nachyleniu i hierarchię coraz bardziej złożonych detektorów, a Fukushima w Neocognitronie (1980) jawnie się do tych badań odwoływał. Architektura z lokalnymi detektorami i uśrednianiem faktycznie ma neurobiologiczną genealogię.
Przesadzone jest słowo „zastosowanie", sugerujące, że CNN wyprowadzono z biologii jak wniosek z przesłanki. Po pierwsze, głównym motywem LeCuna były względy obliczeniowe: współdzielenie wag zmniejszało liczbę parametrów i dawało niezmienniczość na przesunięcie — argumenty w całości matematyczne. Po drugie, jak zauważyliśmy w Jednostce 10.4, hierarchia „krawędzie → części → obiekty" pojawia się w sieciach, których nikt nie modelował na mózgu; wygląda więc na dobry sposób przetwarzania obrazu jako taki, do którego dochodzi się niezależnie — ewolucyjnie i obliczeniowo. Po trzecie, różnic w szczegółach jest tyle, że mówienie o „zastosowaniu" byłoby nadużyciem: propagacja wsteczna nie ma odpowiednika w biologii, a kora wzrokowa nie liczy splotów w sensie dosłownym.
Trafniejsze sformułowanie: „inspiracja biologiczna plus niezależna zbieżność, uzasadniona obliczeniowo".
🔍 Sprawdź, czy umiesz
- [ ] Wyjaśnić, dlaczego CNN analizuje obraz lokalnie, i podać analogię.
- [ ] Wyjaśnić, czym jest pole recepcyjne i dlaczego rośnie z głębokością.
- [ ] Pokazać, jak z rosnącego pola recepcyjnego wynika hierarchia cech.
- [ ] Opowiedzieć historię CNN (1980, 1989, 1998) i wskazać trzy warunki, których brakowało do 2012.
- [ ] Wskazać trzy rzeczy, których metafora „sieć widzi" nie oddaje.