„Poznasz słowo po towarzystwie": hipoteza dystrybucyjna
🎯 Po co Ci to?
One-hot nie niesie sensu. Naturalna reakcja: dopiszmy sens ręcznie — niech każde słowo dostanie liczby opisujące cechy („ile w nim człowiekowatości", „ile puszystości", „czy to czynność"). To świetna intuicja dydaktyczna: pokazuje, czego chcemy od dobrej reprezentacji. Zarazem ujawnia, że ręcznie się tego nie da zrobić na skalę prawdziwego języka. Stąd most do Firtha i do automatycznego uczenia cech.
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- wyjaśnić ideę reprezentacji słowa jako wektora cech (gęstego, krótkiego);
- policzyć odległość euklidesową między dwoma wektorami słów;
- wyjaśnić, dlaczego ręczny wybór setek cech jest praktycznie niemożliwy;
- sformułować hipotezę dystrybucyjną Firtha i powiedzieć, co z niej wynika dla maszyny.
🔁 Przypomnij sobie
Z Jednostki 14.1 wiesz, że one-hot jest rzadki (prawie same zera) i nie koduje podobieństwa. Z Jednostki 10.4 wiesz, że sieć sama buduje reprezentacje warstwami — tu zobaczysz analogiczny problem po stronie wejścia językowego.
📘 Ręczna tabela cech: człowiekowatość, puszystość, czynność
Weźmy te same tokeny co w Jednostce 14.1 i przypiszmy im — na razie ręcznie — trzy cechy. 0 = „nie ma tej cechy", 1 = „ma ją w najwyższym stopniu":
| Token | człowiekowatość | puszystość | czynność |
|---|---|---|---|
| Ala | 1 | 0,2 | 0 |
| ma | 0 | 0 | 1 |
| kota | 0 | 1 | 0 |
| Ja | 1 | 0,1 | 0 |
| mam | 0 | 0 | 1 |
| psa | 0 | 0,9 | 0 |
| Marysia | 1 | 0,2 | 0 |
| czerwonego | 0 | 0 | 0 |
| kanarka | 0 | 0,6 | 0 |
Co z tego wynika?
Po pierwsze — krótsze wektory. „Ala" to teraz (1, 0,2, 0), „kota" to (0, 1, 0) — długość 3 zamiast 9. I nawet gdyby słownik urósł do miliona słów, długość wektora nie musiałaby rosnąć: zależy od liczby cech, nie od rozmiaru słownika.
Po drugie — więcej sensu. Wektor „Ala" (1, 0,2, 0) mówi: to coś w najwyższym stopniu „człowiekowate", trochę puszyste, nie jest czynnością. „Kota" (0, 1, 0): zero człowiekowatości, maksymalna puszystość, nie czynność.
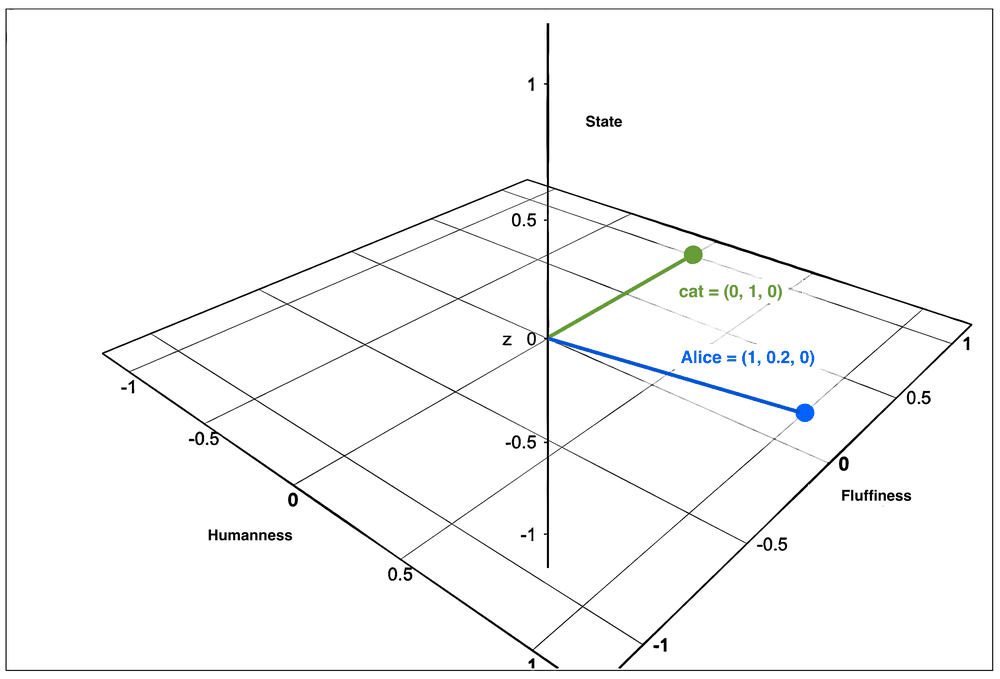
Po trzecie — da się porównywać. Każdą cechę traktujemy jako wymiar / oś. Przy trzech wymiarach da się to narysować.
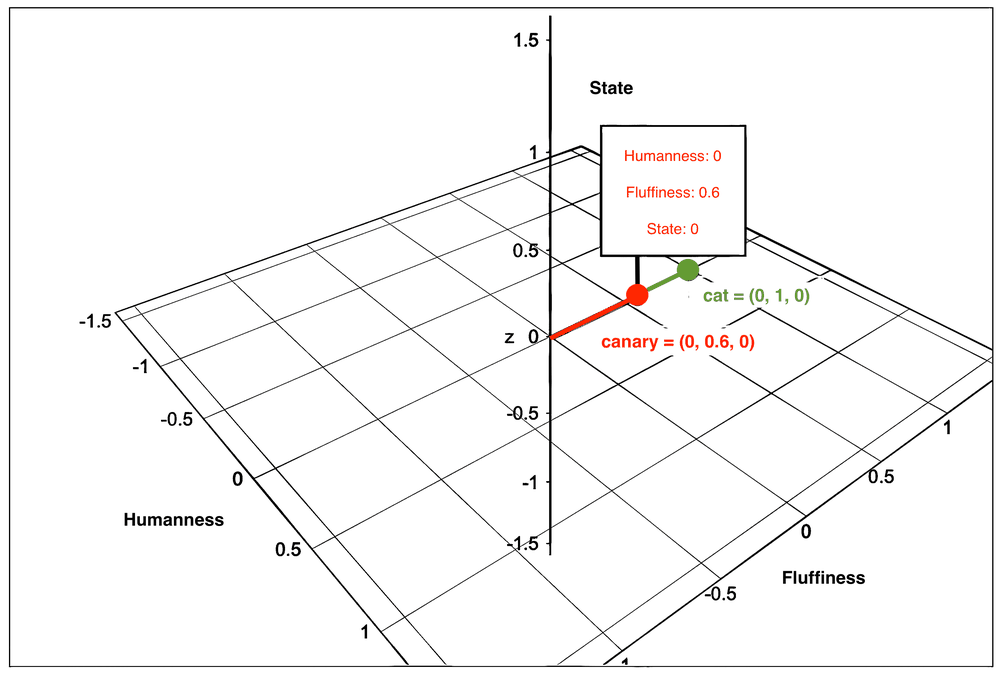
Oba mają człowiekowatość = 0 i czynność = 0, więc porównujemy je na osi puszystości: kot 1,0, kanarek 0,6 — dzieli je 0,4.
„Ala" i „kota" nie leżą na jednej prostej — trzeba policzyć długość odcinka łączącego końce wektorów (odległość euklidesowa):
- Różnice wymiarów:
1 − 0 = 1,0,2 − 1 = −0,8,0 − 0 = 0. - Kwadraty:
1,0,64,0. - Suma:
1,64. - Pierwiastek:
√1,64 ≈ 1,28.
Od „kota" do „kanarka" było 0,4 — więc (w tej trójwymiarowej przestrzeni cech) od kota do kanarka jest ok. trzykrotnie bliżej niż do Ali. Między „Ala" i „Marysia" oraz między „ma" i „mam" dystans wynosi 0 — pełne podobieństwo w przyjętych cechach. Ma to sens.
📐 DEFINICJA — odległość euklidesowa między wektorami słów: pierwiastek z sumy kwadratów różnic odpowiadających sobie współrzędnych; miara „jak daleko" dwa słowa leżą w przestrzeni cech.
Po ludzku: długość najkrótszej linii między dwoma punktami-słowami.
📘 Skala, przy której ręce nie wystarczą
A gdybyśmy chcieli 512 cech — albo 8292? Pojawiają się trzy pytania:
- Jakie cechy wybrać, żeby dobrze reprezentowały cały język?
- Kto oceni stopień posiadania każdej cechy dla każdego słowa?
- Ile to potrwa?
Rachunek ostrzegawczy: słownik 100 000 słów × 512 cech × 1 minuta na ocenę jednej pary (słowo, cecha) ≈ 300 lat pracy jednej osoby po 8 godzin dziennie (także w weekendy). Sto osób: ok. 3 lata — i dopiero potem sprawdzasz, czy reprezentacja w ogóle działa. Jeśli nie: od zera.
Ręczne cechy świetnie uczą intuicji. Jako metoda na prawdziwy język — odpadają.
📘 Firth: poznasz słowo po towarzystwie
W 2013 roku Google odpowiedział na te trzy pytania rewolucyjnie: cechy wybierze sama sieć, sama ustali ich wartości — i zrobi to w dni lub tygodnie, nie w lata.
Pomysł zaczerpnięto od brytyjskiego lingwisty Johna Ruperta Firtha. Firth uważał, że znaczenie słów jest ściśle powiązane z kontekstem ich użycia. Jego słynne stwierdzenie z lat 50. XX wieku:
You shall know a word by the company it keeps!
(Poznasz słowo po towarzystwie, w jakim się znajduje.)
Dodatkowo: słowa występujące w podobnych kontekstach często mają podobne znaczenia. Pewne słowa bardziej się „lubią" i częściej pojawiają się razem. Człowiek czasem to zauważa — ale nie przeanalizuje dla każdego słowa ze słownika, w jakich książkach, artykułach i treściach internetowych występuje, ile razy i w towarzystwie jakich innych słów. Dla komputera takie zadanie to bułka z masłem.
📐 DEFINICJA — hipoteza dystrybucyjna: znaczenie słowa da się (w dużym stopniu) odczytać z rozkładu kontekstów, w których słowo występuje; słowa o podobnych kontekstach mają podobne znaczenia.
Po ludzku: nie pytaj o definicję ze słownika — spójrz, z kim to słowo „się zadaje" w milionach zdań.
💭 Pomyśl
Dlaczego zdanie Firtha jest jednocześnie obietnicą i ograniczeniem? Co komputer może z niego wyciągnąć łatwiej niż człowiek, a czego hipoteza dystrybucyjna nie gwarantuje?
Sprawdź odpowiedź
Obietnica: komputer może zliczyć współwystępowania w skali niemożliwej dla człowieka i zbudować mapę podobieństw bez ręcznych definicji.
Ograniczenie: kontekst w wąskim oknie sąsiadów to nie to samo co pełne rozumienie zdania, ironii czy wiedzy o świecie. Dwa słowa mogą współwystępować często z powodów stylistycznych lub korpusowych, nie „prawdziwego" podobieństwa znaczeń. Hipoteza daje użyteczną matematyczną strukturę, nie gwarancję ludzkiego rozumienia (to pytanie wróci w Dziale 19).
⚠️ Uwaga, pułapka
Tabela z „człowiekowatością" i „puszystością" to metafora dydaktyczna, nie opis tego, co robi word2vec. W prawdziwym osadzeniu wymiary nie mają nazw w stylu „puszystość" — to setki współrzędnych, których znaczenie odczytujemy po fakcie z geometrii (jak filtry CNN w Jednostce 12.2). Nie szukaj w wektorze word2vec kolumny „człowiekowatość".
🌍 Powiązania
Ręczna tabela cech jest kuzynem ręcznie projektowanych filtrów obrazu sprzed CNN (Jednostka 12.2): działa na małą skalę, pada na dużej. Firth dostarcza zasadę, word2vec (14.3) — automatyzację. Odległość euklidesowa wróci przy analogiach wektorowych (14.4).
📐 Definicje tej lekcji
- Wektor cech słowa — krótka lista liczb opisujących intensywność wybranych cech; gęstsza i bogatsza niż one-hot.
- Odległość euklidesowa — miara odległości między wektorami w przestrzeni cech.
- Hipoteza dystrybucyjna (Firth) — znaczenie z kontekstu użycia; podobne konteksty ⇒ podobne znaczenia.
📌 Najważniejsze w pigułce
- Ręczne cechy dają krótkie, sensowne wektory i pozwalają mierzyć podobieństwo — ale nie skalują się do prawdziwego słownika.
- Odległość między wektorami da się policzyć (np. euklidesowo); bliżej = podobniej w przyjętej przestrzeni cech.
- Firth: poznasz słowo po towarzystwie — fundament automatycznego uczenia reprezentacji.
- Word2vec (następna jednostka) każe sieci wybrać cechy i ich wartości z danych.
🎒 Zadania
Zadanie 14.2.1. Policz odległość euklidesową między „psa"
(0, 0,9, 0)a „kanarka"(0, 0,6, 0). Porównaj z odległością kota–kanarka (0,4) z lekcji.
Pokaż rozwiązanie
Różnice: 0, 0,9 − 0,6 = 0,3, 0. Kwadraty: 0 + 0,09 + 0 = 0,09. Pierwiastek: 0,3. Pies jest bliżej kanarka (0,3) niż kot był względem kanarka na rysunku? W lekcji kot–kanarek = 0,4 na osi puszystości (1,0 vs 0,6). Tu pies 0,9 vs kanarek 0,6 daje 0,3 — bliżej. Sens w tej metaforze: pies i kanarek różnią się puszystością mniej niż kot i kanarek w przyjętej skali — pamiętaj, że to ilustracja, nie zoologia.
Zadanie 14.2.2. Wyjaśnij trzema zdaniami, dlaczego „512 ręcznych cech × 100 000 słów" odpada jako metoda budowy reprezentacji języka.
Pokaż rozwiązanie
(1) Nie wiadomo, jakie cechy wybrać, by pokryły cały język. (2) Ocena wymagałaby armii ekspertów i lat pracy — rachunek daje rząd wielkości lat/osób-lat. (3) Dopiero na końcu okazałoby się, czy reprezentacja działa; przy porażce koszt startuje od zera. Automatyczne uczenie cech z kontekstu omija ten impas.
Zadanie 14.2.3. Sformułuj hipotezę dystrybucyjną własnymi słowami i podaj jeden przykład pary słów, które według niej powinny dostać bliskie wektory — oraz jedną parę, przy której sama współwystępowalność może zmylić.
Pokaż rozwiązanie
Hipoteza: słowa o podobnych kontekstach użycia mają podobne znaczenie; mapę znaczeń da się budować ze statystyki sąsiedztwa.
Bliska para (przykład): „lekarz" i „doktor" — podobne otoczenia w tekstach.
Para myląca: „dobry" i „zły" często występują w podobnych ramach składniowych („X film", „X człowiek"), więc mogą wyjść bliżej, niż sugeruje antonimia — kontekst dystrybucyjny łapie rolę w zdaniu, nie zawsze ocenę moralną.
🔍 Sprawdź, czy umiesz
- [ ] Opisać ideę gęstego wektora cech i wskazać jej przewagę nad one-hot.
- [ ] Policzyć prostą odległość euklidesową.
- [ ] Wyjaśnić, dlaczego ręczne cechy nie skalują się.
- [ ] Sformułować hipotezę dystrybucyjną Firtha.