word2vec i osadzenia słów
🎯 Po co Ci to?
Mamy zasadę Firtha i wiemy, że ręcznych cech nie damy rady. Brakuje mechanizmu: jak sieć ma się nauczyć wektorów z towarzystwa słów. Tym mechanizmem jest word2vec (2013) — metoda, która uczy się przewidywać brakujące słowo w oknie kontekstu, a przy okazji, jako produkt uboczny, buduje osadzenia słów.
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- opisać okno kontekstu i przykład treningowy word2vec (CBOW);
- wyjaśnić, skąd biorą się osadzenia (wagi warstwy ukrytej);
- powiedzieć, czym word2vec różni się od one-hot i od ręcznej tabeli cech;
- wskazać, jak sprawdza się jakość osadzeń (bliskość, analogie — rozwinięcie w 14.4).
🔁 Przypomnij sobie
Z Jednostki 14.1 znasz one-hot i słownik. Z 14.2 — hipotezę dystrybucyjną. Z Jednostki 10.2 — warstwę ukrytą i wagi. Z Jednostki 9.1 — uczenie nienadzorowane: system uczy się struktury z danych bez ręcznych etykiet znaczeń. Word2vec jest właśnie taki: etykietą jest samo słowo w kontekście, wzięte z surowego tekstu.
📘 Okno wokół słowa „ma"
Wróćmy do trzech zdań i skupmy się na słowie „ma". Znajdźmy wystąpienia i spójrzmy na jedno słowo z lewej i jedno z prawej — to okno kontekstu:
- Ala ma kota.
- Marysia ma czerwonego kanarka.
Z każdego wystąpienia robimy materiał do uczenia sieci (wariant CBOW — continuous bag of words: z kontekstu przewidujemy środek):
| wejście (sąsiedzi) | wyjście (środek) |
|---|---|
| Ala, kota | ma |
| Marysia, czerwonego | ma |
Po zamianie na one-hot (słownik z 14.1):
Przykład 1
wejście: (1,0,0,0,0,0,0,0,0) („Ala") i (0,0,0,0,1,0,0,0,0) („kota")
wyjście: (0,0,0,0,0,1,0,0,0) („ma" — indeks 6 w słowniku alfabetycznym z 14.1).
Przykład 2
wejście: Marysia i czerwonego → wyjście: ma.
📐 DEFINICJA — okno kontekstu: ustalone sąsiedztwo słów wokół słowa docelowego (np. jedno z lewej i jedno z prawej), z którego model uczy się relacji dystrybucyjnych.
📘 Sieć, która przewiduje brakujące słowo
Budujemy sieć, która:
- na wejściu i wyjściu ma V neuronów (V = rozmiar słownika, tu 9),
- ma jedną warstwę ukrytą z N neuronami — N to liczba cech, które chcemy, by komputer sam wytworzył (np. N = 512).
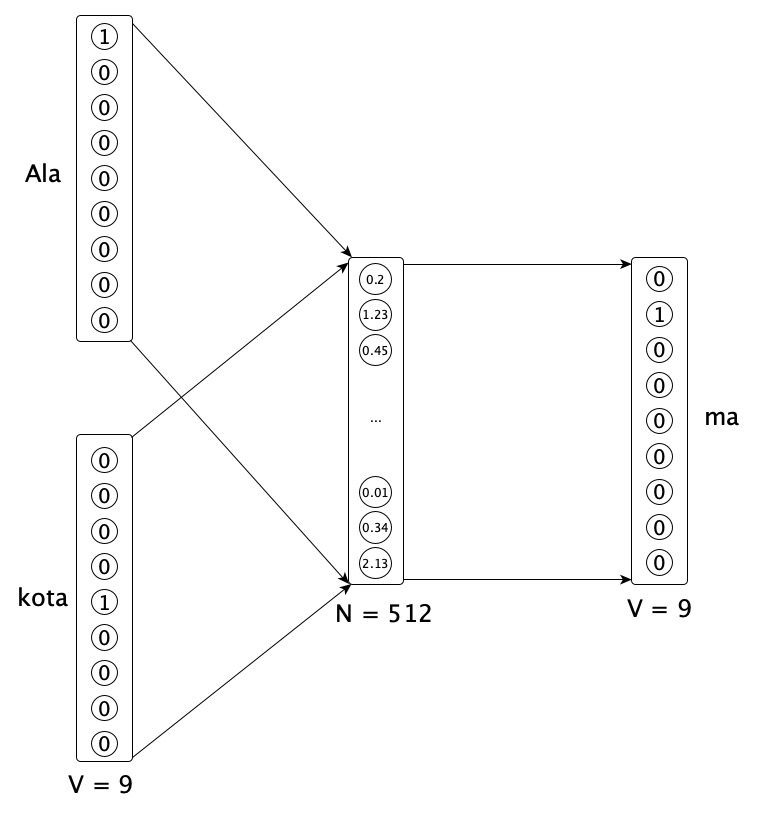
Sieć uczy się predykcji brakującego słowa w oknie. Podczas uczenia wagi między wejściem a warstwą ukrytą można ułożyć w tabelę V × N (9 wierszy × 512 kolumn) — dokładnie jak wyobrażona wcześniej tabela cech, tylko wypełniona przez trening, nie przez ekspertów.
Każdy wiersz tej tabeli to wektor danego tokenu. Te wektory nazywamy osadzeniami słów (word embeddings). Powstają jako produkt uboczny uczenia zależności między słowem a jego kontekstem.
📐 DEFINICJA — word2vec: metoda (Mikolov i współpracownicy, Google, 2013) ucząca się wektorowych reprezentacji słów z kontekstu w dużych korpusach tekstu — bez ręcznych definicji słownikowych.
Po ludzku: sieć zgaduje brakujące słowo z sąsiadów; „przy okazji" każde słowo dostaje punkt w przestrzeni znaczeń.
📐 DEFINICJA — osadzenie słowa (word embedding): wektor liczb reprezentujący słowo tak, by słowa o podobnym znaczeniu (dystrybucyjnie) leżały blisko siebie.
Czym to NIE jest: to nie definicja ze słownika i nie lista nazwanych cech („puszystość"). Wymiary są abstrakcyjne; sens widać w geometrii między punktami.
📘 Skąd wiemy, że osadzenia mają sens?
Kilka testów:
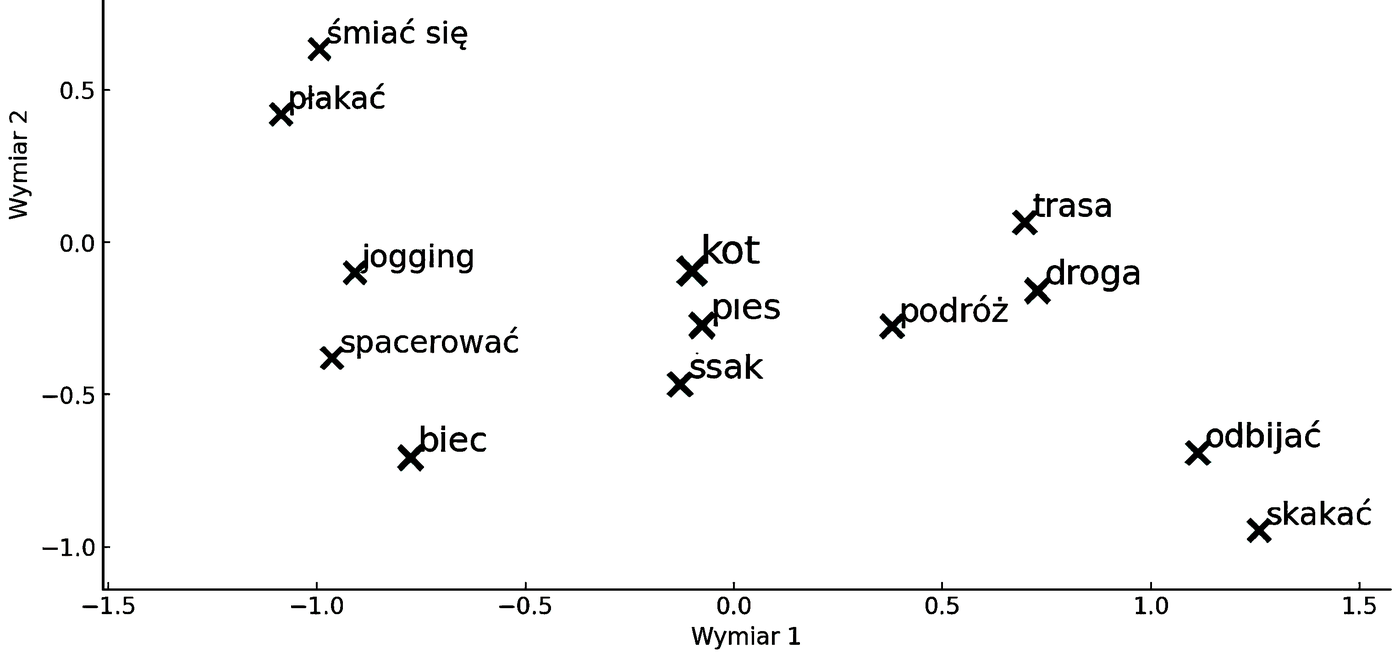
- Bliskość. Podobne słowa powinny leżeć blisko po zredukowaniu 512 wymiarów do 2–3 (techniki w rodzaju t-SNE / PCA — bez wchodzenia w szczegóły).
- Analogie. Semantyczna: „Budapeszt ma się do Węgier jak Warszawa do …" → Polski. Syntaktyczna: „ma" ma się do „miał" jak „siedzi" do … → siedział. Jeśli wektory tego nie łapią — osadzenia są słabe. Rozwijamy to w Jednostce 14.4.
💭 Pomyśl
Dlaczego mówimy, że osadzenia powstają „przy okazji"? Czy sieć „chciała" zbudować mapę znaczeń?
Sprawdź odpowiedź
Sieć dostała zadanie predykcji: z kontekstu odgadnij środkowe słowo (albo odwrotnie — w wariancie Skip-gram). Funkcja straty karze złe zgadywanie. Żeby dobrze zgadywać, warstwa ukryta musi wewnętrznie ułożyć słowa tak, by podobne konteksty dawały podobne sygnały — a to właśnie wypycha podobne znaczeniowo słowa blisko siebie w przestrzeni wag. Mapy znaczeń nikt nie wpisał w cel treningu wprost; wyłoniła się jako reprezentacja pomocna do predykcji — ten sam trop co reprezentacje w głębszych warstwach CNN (Jednostka 10.4 / 12.4).
⚠️ Uwaga, pułapka
Osadzenie pojedynczego słowa w klasycznym word2vec jest stałe: „zamek" zawsze dostaje ten sam wektor, niezależnie od zdania. Model nie odróżnia zamku-budowli od zamka w kurtce. To nie drobny szczegół — to główna motywacja transformerów (Dział 16), gdzie reprezentacja tokenu zależy od całego kontekstu.
🌍 Powiązania
Word2vec łączy nogę statystyczno-językową (Firth, dystrybucja) z nogą neuronową (Część III). Most do modelu językowego (Dział 15): tam też chodzi o przewidywanie następnego słowa — tylko w skali całego ciągu, nie krótkiego okna. Most do transformerów (Dział 16): kontekst zamiast stałego punktu.
📐 Definicje tej lekcji
- Okno kontekstu — sąsiedztwo wokół słowa docelowego.
- CBOW — wariant: z kontekstu przewidujemy słowo środkowe.
- word2vec — metoda uczenia osadzeń z kontekstu (Mikolov, 2013).
- Osadzenie słowa — wektor (wiersz tabeli V×N) reprezentujący słowo w przestrzeni znaczeń.
📌 Najważniejsze w pigułce
- Word2vec uczy się z towarzystwa słów: przewiduje brakujące słowo w oknie.
- Osadzenia = wagi / wiersze związane z warstwą ukrytą — produkt uboczny predykcji.
- Dostajemy wektory krótkie (N), gęste i niosące podobieństwo — w przeciwieństwie do one-hot.
- Jakość sprawdzamy bliskością i analogiami; ograniczenie: jeden stały wektor na słowo.
🎒 Zadania
Zadanie 14.3.1. Dla zdania „Ja mam psa" i okna ±1 wokół „mam" zapisz parę (wejście → wyjście) w stylu CBOW.
Pokaż rozwiązanie
Sąsiedzi: „Ja" (lewa) i „psa" (prawa); środek: „mam".
Wejście: Ja, psa → wyjście: mam.
(Po one-hot: wektory odpowiadające indeksom tych trzech tokenów w słowniku.)
Zadanie 14.3.2. Wyjaśnij, dlaczego word2vec rozwiązuje (częściowo) trzy problemy one-hot z Jednostki 14.1.
Pokaż rozwiązanie
(1) Sens / podobieństwo: słowa o podobnych kontekstach dostają bliskie wektory. (2) Rozmiar: długość wektora to N (np. 300–512), nie V — nie rośnie z każdym nowym słowem słownika tak jak one-hot. (3) Kolejność: w samym worku okna CBOW kolejność sąsiadów jest uproszczona (stąd „bag of words"), ale model i tak wykorzystuje lokalne sąsiedztwo zamiast globalnego worka całego dokumentu; pełniejsze modelowanie kolejności w długich ciągach to domena RNN/transformerów (Działy 15–16). Word2vec nie „załatwia języka w całości" — załatwia reprezentację słowa.
Zadanie 14.3.3. Czym różni się „cecha" w ręcznej tabeli z 14.2 od wymiaru osadzenia word2vec?
Pokaż rozwiązanie
W tabeli ręcznej cecha ma nazwę i interpretację z góry („puszystość"). W word2vec wymiary są wyuczone i zwykle nie mają czytelnej etykiety; interpretujemy je pośrednio (które słowa są blisko, jakie analogie działają). To ta sama różnica co między ręcznym filtrem Sobela a filtrem CNN (Jednostka 12.2).
🔍 Sprawdź, czy umiesz
- [ ] Opisać okno i przykład treningowy CBOW.
- [ ] Wyjaśnić, skąd biorą się osadzenia.
- [ ] Porównać word2vec z one-hot i z ręcznymi cechami.
- [ ] Wskazać ograniczenie stałego wektora.