Czym jest model językowy: przewidywanie następnego słowa
🎯 Po co Ci to?
Osadzenia mówią, gdzie leży słowo w przestrzeni znaczeń. Model językowy mówi, co będzie dalej. To jest silnik generowania tekstu — i zarazem najprostsze zadanie, na którym da się uczyć sieć z samego tekstu, bez ręcznych etykiet „to jest pytanie / to jest odpowiedź".
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- zdefiniować model językowy jako przewidywanie następnego tokenu;
- zbudować przykłady treningowe przez przesuwanie okna po tekście;
- opisać wejście/wyjście sieci (wektory → rozkład na słownik);
- zauważyć, że taki model przy okazji może wytworzyć osadzenia (jak word2vec).
🔁 Przypomnij sobie
Z Jednostki 14.3 wiesz, że word2vec uczy się osadzeń, przewidując brakujące słowo w oknie kontekstu. Z Jednostki 10.3 — że Softmax zamienia wyniki warstwy na rozkład prawdopodobieństwa po klasach (tu: po tokenach słownika).
📘 Definicja
📐 DEFINICJA — model językowy: sztuczna sieć neuronowa, która dla danego ciągu słów (tokenów) potrafi wskazać, jakie słowo lub token pojawi się jako następne.
Po ludzku: maszyna zgaduje kontynuację tekstu. Dzisiejsze duże modele (ChatGPT i podobne) to właśnie modele językowe — tylko ogromne i inaczej zbudowane (Działy 16–17).
Dzisiejsze modele wykorzystują osadzenia słów. Da się jednak zbudować model językowy także na wektorach z gorącą jedynką (Jednostka 14.1) — dokładnie tak, jak w przykładzie poniżej.
📘 Okno i przykłady treningowe
Uczymy model podobnie jak przy osadzeniach: wybieramy okno. Przyjmijmy okno rozmiaru 2 (dwa słowa wejścia → jedno wyjście). Dla kolekcji tekstów przesuwamy okno i zbieramy przykłady. Weźmy znowu trzy zdania z Działu 14:
- Ala ma kota.
- Ja mam psa.
- Marysia ma czerwonego kanarka.
Przesuwając okno (pogrubione = kontekst wejściowy; następne słowa to to, czego sieć ma się nauczyć przewidywać w kolejnych krokach):
- Ala ma kota
- Ala ma kota. Ja
- Ala ma kota. Ja mam
- Ala ma kota. Ja mam psa
- Ala ma kota. Ja mam psa. Marysia
- Ala ma kota. Ja mam psa. Marysia ma
- Ala ma kota. Ja mam psa. Marysia ma czerwonego
- Ala ma kota. Ja mam psa. Marysia ma czerwonego kanarka.
Dla pierwszego przykładu:
| wejście | Ala · ma |
| wyjście | kota |
Po zamianie na wektory z gorącą jedynką (słownik z Jednostki 14.1 — 9 tokenów):
| wejście | (1,0,0,0,0,0,0,0,0) · (0,1,0,0,0,0,0,0,0) |
| wyjście | (0,0,0,0,1,0,0,0,0) |
Cel treningu: sieć dla wejścia „Ala ma" ma wskazać „kota" jako najbardziej prawdopodobne kolejne słowo — i analogicznie dla pozostałych okien.
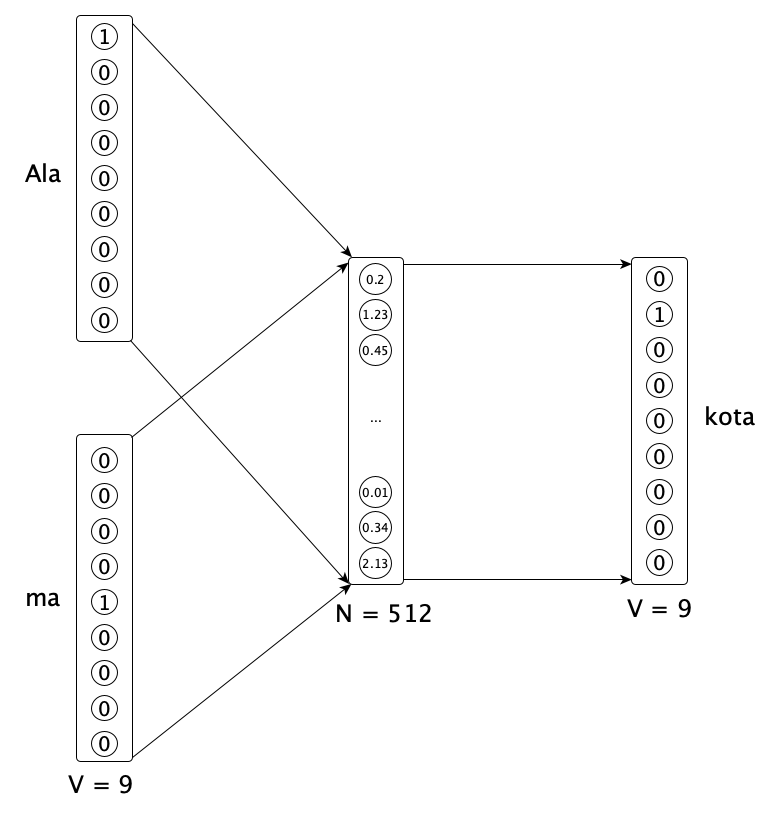
Architektura wygląda podobnie jak sieć ucząca osadzeń (CBOW, Jednostka 14.3). Różnica intencji: tu główne zadanie to predykcja następnego tokenu; osadzenia w warstwie ukrytej mogą powstać jako produkt uboczny — dokładnie jak przy word2vec.
💭 Pomyśl
Czy model językowy „rozumie" zdanie „Ala ma kota", skoro nauczył się tylko, że po „Ala ma" często pada „kota"? Co musiałoby się zmienić, żeby mówić o rozumieniu, a nie o statystyce kontynuacji?
Podpowiedź
Na tym etapie model uczy się częstości kontynuacji w danych. Może generować tekst wyglądający sensownie, nie mając osobnego modułu „znaczenia". Pytanie o rozumienie wraca w Części V — tu wystarczy: zdolność przewidywania następnego tokenu to potężne zadanie proxy, nie tożsamość z ludzkim rozumieniem.
⚠️ Częsty błąd
Częsty błąd: mylenie modelu językowego z wyszukiwarką albo z bazą wiedzy („ma w środku fakty").
Elenchus: Jeśli model tylko przewiduje następny token na podstawie wzorców w tekście treningowym, to skąd miałby brać gwarancję prawdziwości faktu, którego nigdy nie widział albo który w internecie występuje rzadziej niż popularny mit?
🌍 Powiązania
- word2vec (14.3) — to samo okno, inny cel (brakujące słowo vs następne).
- Softmax (10.3) — wyjście to rozkład po słowniku.
- ChatGPT (17) — ten sam kontrakt „następny token", inna skala i douczanie.
📐 Definicje tej lekcji
- Model językowy — sieć przewidująca następny token dla danego ciągu.
- Okno kontekstu — ile poprzednich tokenów widzi model przy jednej predykcji (tu: 2).
- Przykład treningowy LM — para (ciąg wejściowy, token docelowy) wycięta z tekstu.
📌 Najważniejsze w pigułce
- Model językowy = „co jest następne?".
- Uczymy go na oknach przesuwanych po tekście — bez ręcznych etykiet tematycznych.
- Wejście: wektory tokenów; wyjście: rozkład prawdopodobieństwa po słowniku.
- Przy okazji mogą powstać osadzenia — jak przy word2vec.
🎒 Zadania
Zadanie 15.1.1. Dla tekstu „Ja mam psa" i okna rozmiaru 2 wypisz wszystkie pary (wejście → wyjście).
Pokaż rozwiązanie
Przy tokenach Ja, mam, psa (bez kropki):
- Ja mam → psa
(Jedno pełne okno 2→1; krótszy tekst niż w przykładzie z trzema zdaniami.)
Zadanie 15.1.2. Czym różni się zadanie modelu językowego od CBOW (word2vec), jeśli oba używają okna i Softmaxu?
Pokaż rozwiązanie
CBOW przewiduje słowo w środku z kontekstu wokół; model językowy przewiduje następne słowo z poprzedzającego ciągu (kierunek „w przyszłość"). Intencja użytkowa: LM generuje kontynuację; word2vec głównie produkuje osadzenia.
🔍 Sprawdź, czy umiesz
- [ ] Zdefiniować model językowy jednym zdaniem.
- [ ] Zbudować przykłady z okna na krótkim tekście.
- [ ] Opisać wejście/wyjście sieci.
- [ ] Powiązać LM z word2vec i Softmaxem.