Sieci rekurencyjne (RNN): pętla w czasie
🎯 Po co Ci to?
Sieci gęste (Część III) traktują wejście jak wektor „tu i teraz". Tekst jest ciągiem. RNN (recurrent neural networks) dostały pętlę: to, co sieć „pamięta" po słowie t, wchodzi do obliczeń przy słowie t+1. W latach 2013–2017 to była dominująca architektura NLP — zwłaszcza w tłumaczeniu.
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- opisać stan ukryty jako pamięć RNN;
- przejść krok po kroku przykład „Ala ma" → „kota";
- wyjaśnić, po co wiele warstw ukrytych;
- nazwać zanik gradientu jako chorobę długich sekwencji.
🔁 Przypomnij sobie
Propagacja wsteczna (11.3): uczenie = aktualizacja wag na podstawie gradientu błędu. Zanikający gradient (11.5): gdy gradient jest wielokrotnie mnożony przez małe liczby, sygnał uczący gaśnie.
📘 Pamięć = stan ukryty
RNN wynaleziono już w latach 80., ale szczyt zastosowań w języku przypadł na 2013–2017. Klucz: zdolność do „zapamiętywania" tego, co było wcześniej. Realizacja: rekurencyjne połączenia — wyjście warstwy ukrytej wraca jako wejście w następnym kroku czasu.
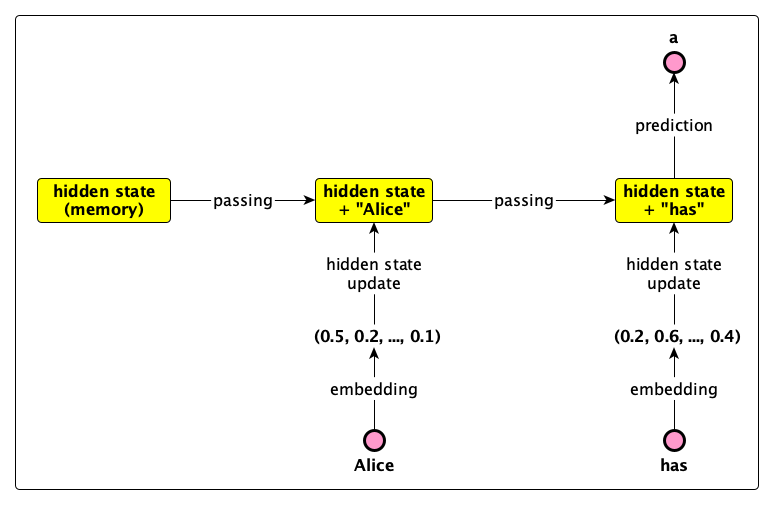
Przykład. Wejście: sekwencja „Ala ma"; wyjście: „kota".
- Inicjujemy stan ukryty (pamięć) — wektor, często zerami lub losowo. Rozmiar stanu ma znaczenie: większy → bogatsze wzorce, droższy trening.
- Dostajemy osadzenie „Ala"; aktualizujemy stan — teraz niesie informacje o „Ala".
- Dostajemy osadzenie „ma"; aktualizujemy stan ponownie — teraz „Ala ma".
- Z finalnego stanu, przez warstwę gęstą i Softmax, wybieramy najbardziej prawdopodobne następne słowo — „kota".
RNN może mieć kilka warstw ukrytych; zasada zostaje ta sama: stan (stany) przenosi pamięć przez kroki.
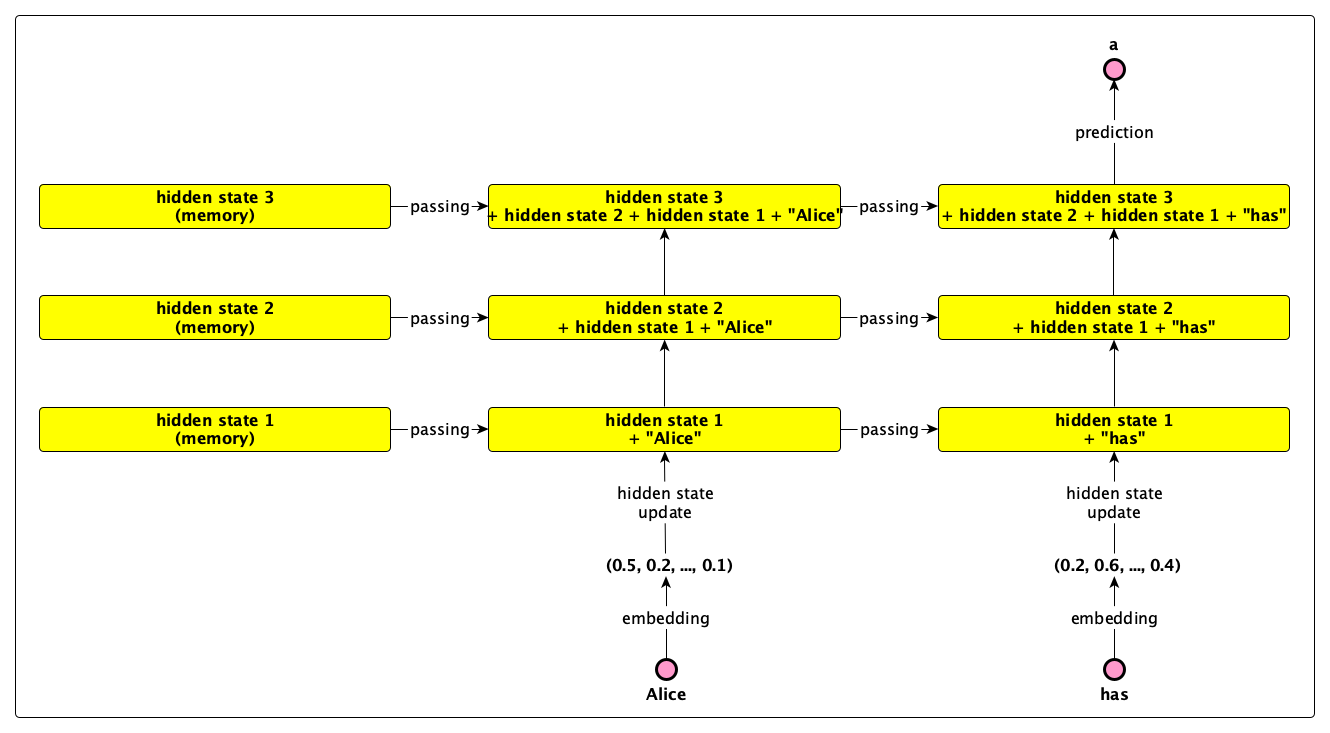
📐 DEFINICJA — sieć rekurencyjna (RNN): architektura, w której stan ukryty z kroku t wchodzi do obliczeń w kroku t+1, dzięki czemu sieć przetwarza sekwencję z pamięcią historii.
📐 DEFINICJA — stan ukryty (w RNN): wektor wewnętrzny aktualizowany po każdym tokenie; nośnik „pamięci" tego, co już przetworzono.
📘 Zanik gradientu w czasie
Podstawowe RNN „cierpiały" na zanikanie gradientu przy długich sekwencjach. Gradient błędu idzie wstecz przez każdy krok; po drodze jest wielokrotnie mnożony. Iloczyn ułamków szybko zmierza do zera (½·½ = ¼…). Sieć nie dostaje sygnału, jak poprawić wczesne kroki — i nie uczy się długich zależności.
To ten sam mechanizm co w głębokich sieciach w głąb warstw (11.5), tylko tu „głębia" to długość tekstu w czasie.
💭 Pomyśl
Dlaczego zrównoleglenie treningu RNN na GPU jest trudniejsze niż trening CNN na obrazach? (Wskazówka: kolejność kroków.)
Podpowiedź
Krok t+1 zależy od stanu po kroku t. Nie policzysz wszystkich pozycji zdania naraz niezależnie — musisz iść sekwencyjnie. CNN na obrazie liczy wiele filtrów / lokalizacji równolegle. Ten brak paralelizmu wróci jako motywacja transformera (16).
⚠️ Częsty błąd
Częsty błąd: „RNN rozumie zdanie tak jak człowiek, bo ma pamięć."
Elenchus: Pamięć RNN to wektor liczb aktualizowany lokalną regułą — nie narracja ani świadome przypominanie. Na długim tekście i tak gaśnie. Metafora pomaga; nie myl jej z psychologią.
🌍 Powiązania
- 11.5 — zanik gradientu; tu w osi czasu.
- 15.4 — LSTM łata pamięć bramkami.
- 16 — wyrzucenie rekurencji na rzecz uwagi + paralelizm.
📐 Definicje tej lekcji
- RNN — sieć z pętlą stanu w czasie.
- Stan ukryty — wektor pamięci po kolejnych tokenach.
- Zanik gradientu (w RNN) — sygnał uczący gaśnie na długiej sekwencji.
📌 Najważniejsze w pigułce
- RNN czyta słowo po słowie i aktualizuje stan ukryty.
- Softmax na końcu → następny token.
- Zaleta: sekwencja zamiast worka; wada: zanik gradientu + brak paralelizmu.
- Lata 2013–2017: królowa NLP — zanim wszedł transformer.
🎒 Zadania
Zadanie 15.3.1. Opisz trzema krokami, co dzieje się ze stanem ukrytym przy wejściu „Ala", potem „ma", zanim padnie predykcja „kota".
Pokaż rozwiązanie
(1) Init stanu. (2) Wejście osadzenia „Ala" → nowy stan. (3) Wejście „ma" + poprzedni stan → stan „Ala ma"; z niego Softmax wybiera „kota".
Zadanie 15.3.2. Wyjaśnij analogię: głęboka sieć warstwami ↔ RNN krokami czasu — w kontekście zanikającego gradientu.
Pokaż rozwiązanie
W obu przypadkach gradient jest łańcuchem mnożeń. W CNN/MLP — przez warstwy w głąb; w RNN — przez kroki wstecz w czasie. Długa głębokość / długi tekst → iloczyn małych czynników → ≈ 0 → brak uczenia wczesnych części.
🔍 Sprawdź, czy umiesz
- [ ] Zdefiniować RNN i stan ukryty.
- [ ] Przejść przykład „Ala ma" → „kota".
- [ ] Wyjaśnić zanik gradientu w RNN.
- [ ] Wskazać brak paralelizmu jako koszt.