LSTM: pamięć długa i krótka
🎯 Po co Ci to?
LSTM (Long Short-Term Memory, Hochreiter i Schmidhuber, 1997) czekało prawie dwie dekady na swój moment. Od ok. 2016 Google Translate opierał się na wielu warstwach LSTM. Bramki i stan komórki pozwalają lepiej nieść informację przez czas — bez natychmiastowego zanikania gradientu jak w zwykłym RNN.
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- powiedzieć, czym LSTM różni się od zwykłego RNN (bramki + stan komórki);
- opisać rolę bramki zapomnienia, wejścia i wyjścia na przykładzie „Ala ma" → „kota";
- wskazać pozostałe limity: koszt, czas treningu, wciąż ograniczona długość „pamięci".
🔁 Przypomnij sobie
W zwykłym RNN jedyna pamięć to stan ukryty, nadpisywany w każdym kroku. Zanik gradientu (15.3, 11.5) zabija uczenie na długich ciągach.
📘 Bramki zamiast jednego nadpisania
W podstawowym RNN każdy krok bierze wejście i poprzedni stan ukryty i produkuje nowy stan — jedna ścieżka pamięci. LSTM dodaje:
- bramkę zapomnienia (forget gate) — ile starego stanu komórki zachować;
- bramkę wejściową — ile nowych informacji z bieżącego tokenu dopisać;
- bramkę wyjściową — która część stanu komórki wpłynie na stan ukryty przekazywany dalej;
- stan komórki (cell state) — tor z minimalną ingerencją, którym informacja (i gradient) może płynąć dłużej.
Warianty: m.in. GRU (Gated Recurrent Units, 2014) — podobna ideowo, mniej parametrów.
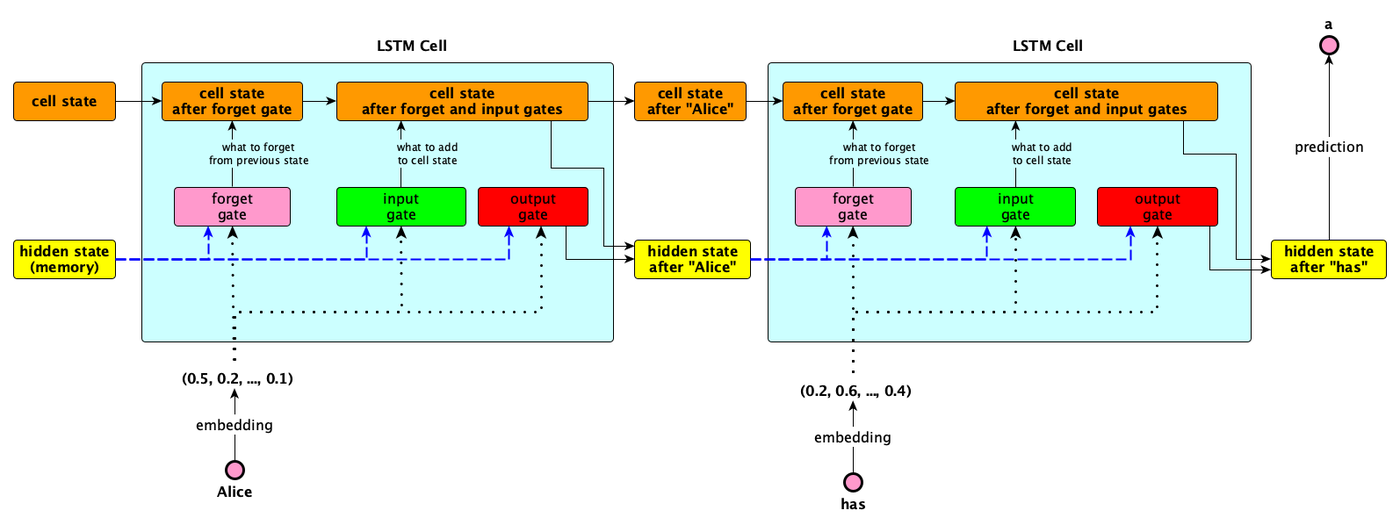
Przykład (jak w książce). Wejście „Ala ma", wyjście „kota".
- „Ala" → osadzenie. Forget gate: na starcie mało do zapomnienia. Input gate: co z „Ala" wpuścić do stanu komórki. Aktualizacja komórki. Output gate: co z komórki trafia do stanu ukrytego.
- To samo dla „ma", ale już ze stanem po „Ala" — komórka i stan ukryty łączą obie informacje.
- Z końcowego stanu ukrytego Softmax wybiera „kota".
Dzięki komórce gradient może przejść wiele kroków bez ciągłego mnożenia przez małe pochodne na całej drodze — stąd lepsze długoterminowe zależności niż w zwykłym RNN.
📐 DEFINICJA — LSTM: wariant RNN z bramkami i stanem komórki, zaprojektowany tak, by lepiej zachowywać informacje (i gradient) przez wiele kroków czasu.
📐 DEFINICJA — stan komórki: dodatkowy tor pamięci w LSTM, aktualizowany selektywnie przez bramki.
📘 Limity inżynierskie
LSTM nie jest magią:
- więcej parametrów → większe wymagania obliczeniowe i pamięciowe;
- często dłuższy trening niż prostszy RNN;
- pamięć lepsza, nie nieskończona — bardzo długie sekwencje wciąż sprawiają trudność;
- przetwarzanie nadal sekwencyjne — brak pełnego paralelizmu (jak w 15.3).
💭 Pomyśl
Po co w ogóle „bramka zapomnienia"? Czy sieć nie powinna pamiętać wszystkiego?
Podpowiedź
Nie wszystko z przeszłości jest relevantne. Zapominanie szumu (stare, nieistotne detale) jest częścią dobrej pamięci — inaczej stan puchnie od śmieci i utrudnia decyzje. Bramka uczy się, co warto nieść dalej.
⚠️ Częsty błąd
Częsty błąd: „LSTM rozwiązało zanik gradientu całkowicie, więc transformer nie był potrzebny."
Elenchus: Jeśli LSTM wystarczałby na dowolnie długi tekst i skalował się tanio, po co Google w 2017 wyrzucałby rekurencję z tłumaczenia maszynowego?
🌍 Powiązania
- 11.5 — zapowiedź LSTM przy zaniku gradientu.
- 13 — era deep learningu; LSTM w tłumaczeniu Google.
- 15.5 / 16 — seq2seq na LSTM, potem transformer bez RNN.
📐 Definicje tej lekcji
- LSTM (1997) — Long Short-Term Memory; bramki + komórka.
- Forget / input / output gate — kontrola zapominania, zapisu, odczytu.
- GRU (2014) — uproszczony kuzyn z bramkami.
📌 Najważniejsze w pigułce
- LSTM = RNN + selektywna pamięć (bramki, komórka).
- Lepiej niesie długie zależności i gradient niż zwykły RNN.
- Nadal drogi, sekwencyjny i nieidealny na bardzo długi tekst.
- Most do seq2seq i — później — do decyzji „wyrzućmy pętlę".
🎒 Zadania
Zadanie 15.4.1. Dopasuj: forget gate / input gate / output gate / cell state — do ról: (a) tor długiej pamięci, (b) ile starego wyrzucić, (c) ile nowego wpuścić, (d) co pokazać jako stan ukryty.
Pokaż rozwiązanie
(a) cell state · (b) forget · (c) input · (d) output.
Zadanie 15.4.2. Wymień trzy powody, dla których mimo LSTM szukano jeszcze innej architektury (pod kątem Działu 16).
Pokaż rozwiązanie
(1) Koszt i czas treningu (wiele parametrów). (2) Brak paralelizmu (krok po kroku). (3) Pamięć wciąż słabnie na bardzo długich sekwencjach. Transformer atakuje zwłaszcza (2) i jakość długiego kontekstu przez uwagę.
🔍 Sprawdź, czy umiesz
- [ ] Odróżnić LSTM od zwykłego RNN.
- [ ] Opisać bramki na przykładzie „Ala ma".
- [ ] Wskazać limity LSTM.
- [ ] Powiązać z zanikiem gradientu.