seq2seq: koder–dekoder i tłumaczenie maszynowe
🎯 Po co Ci to?
Model językowy z 15.1–15.4 przewiduje jeden następny token. Tłumaczenie i streszczenie wymagają: cała sekwencja wejściowa → cała sekwencja wyjściowa. seq2seq (Google, 2014) składa się z enkodera i dekodera (zwykle LSTM): najpierw „wczytaj i streszcz w stan", potem „pisz token po tokenie aż do końca".
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- wyjaśnić kontrakt seq2seq (sekwencja → sekwencja);
- opisać rolę enkodera i dekodera;
- powiedzieć, po co znacznik <EOS>;
- wskazać dziedziczone wady RNN/LSTM (brak paralelizmu, słabnąca pamięć na długim tekście).
🔁 Przypomnij sobie
LSTM (15.4) niesie stan ukryty i stan komórki przez kroki. Softmax wybiera kolejny token. Tłumaczenie to nie „jedno słowo odpowiedzi", tylko zdanie docelowe.
📘 Od jednego tokenu do całej sekwencji
Przykłady zastosowań:
- tłumaczenie — zdanie PL → zdanie EN;
- streszczenie — artykuł → krótszy ciąg tokenów;
- ogólnie: dowolne mapowanie ciąg → ciąg.
Architektura: enkoder przetwarza wejście i buduje reprezentację całej sekwencji (finalny stan ukryty + stan komórki jako „podsumowanie"). Dekoder startuje od tej reprezentacji i generuje wyjście token po tokenie, aktualizując własne stany.
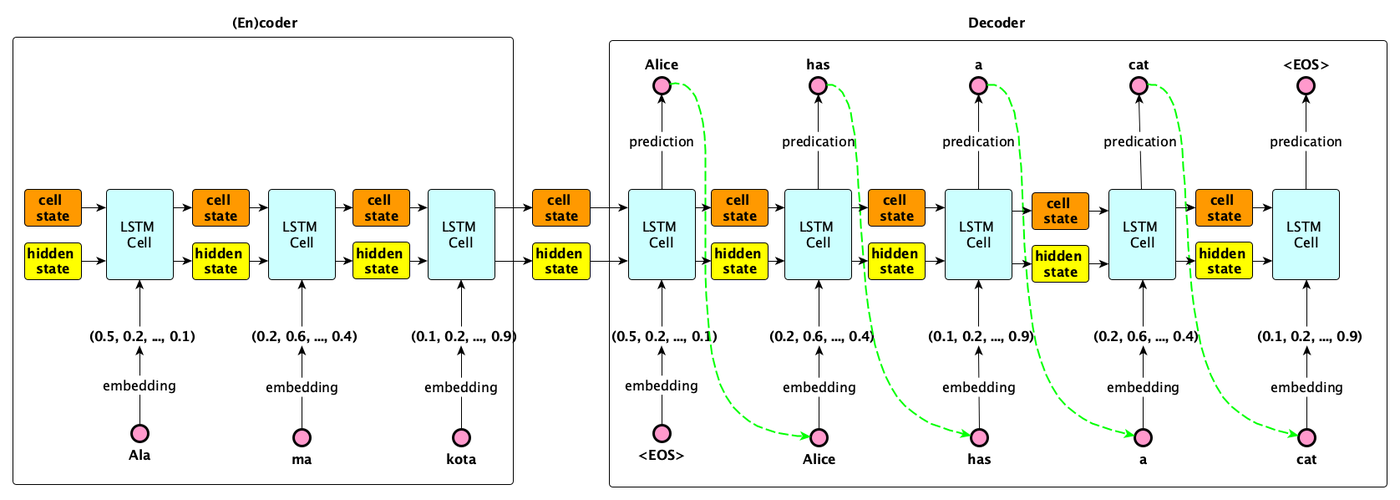
Przykład. Wejście: „Ala ma kota". Każde słowo → osadzenie → komórki LSTM enkodera. Na końcu: semantyczne „podsumowanie" zdania w stanach. Dekoder generuje np. „Alice has a cat": każde nowe słowo korzysta z poprzedniego stanu; stany się aktualizują.
<EOS> (end of sequence): znacznik końca. Dekoder generuje, aż sam wyprodukuje <EOS> — bez niego mógłby ciągnąć w nieskończoność. Na wejściu / starcie dekodowania używa się też znaczników początku sekwencji (w zależności od implementacji).
📐 DEFINICJA — seq2seq: model „od sekwencji do sekwencji": mapuje ciąg tokenów wejścia na ciąg tokenów wyjścia (np. tłumaczenie).
📐 DEFINICJA — enkoder / dekoder: część czytająca wejście do reprezentacji; część generująca wyjście z tej reprezentacji (i dotychczasowych własnych tokenów).
📐 DEFINICJA — <EOS>: token końca sekwencji; sygnał stopu dla dekodera.
📘 Te same wady, większa stawka
seq2seq dziedziczy zalety RNN/LSTM (pamięć sekwencji) i ich wady:
- brak paralelizmu — uczenie czasochłonne i kosztowne;
- pamięć LSTM słabnie wraz z długością — długie zdania źródłowe trudniej „utmulić" w jednym finalnym stanie.
Właśnie te dwa problemy (koszt / paralelizm oraz długie sekwencje) zespół Google adresował dalej — owocem był artykuł 2017 Attention Is All You Need i transformer (Dział 16): zostaje enkoder–dekoder i osadzenia, znika rekurencja; kontekst bierze uwaga, porządek — kodowanie pozycyjne.
💭 Pomyśl
Dlaczego „ściśnięcie" całego długiego zdania źródłowego do jednego finalnego wektora enkodera jest ryzykownym wąskim gardłem?
Podpowiedź
Im dłuższe wejście, tym więcej informacji musi zmieścić się w jednym stanie — łatwo o utratę szczegółów z początku. To motywacja, by dekoder mógł zaglądać do wszystkich pozycji enkodera (uwaga), a nie tylko do jednego wektora-podsumowania.
⚠️ Częsty błąd
Częsty błąd: mylenie seq2seq z „dwoma osobnymi modelami językowymi sklejonymi taśmą".
Elenchus: Enkoder i dekoder są trenowane wspólnie na parach (źródło, cel); dekoder jest uwarunkowany reprezentacją enkodera, nie dokańcza losowego tekstu w próżni.
🌍 Powiązania
- 15.1 — LM przewiduje jeden token; seq2seq — cały ciąg.
- 16 — transformer: ten sam szkielet enkoder–dekoder, bez RNN.
- 17 — GPT to w praktyce dekoderowy transformer jako model językowy.
📐 Definicje tej lekcji
- seq2seq (2014) — sekwencja → sekwencja; Google, tłumaczenie.
- Enkoder / dekoder — czytanie vs generowanie.
- <EOS> — token końca generowania.
📌 Najważniejsze w pigułce
- seq2seq = enkoder czyta, dekoder pisze aż do <EOS>.
- Zastosowania: tłumaczenie, streszczenie, …
- Wady: koszt sekwencyjności + wąskie gardło długiego wejścia.
- Następny ruch historii: uwaga i transformer (16).
🎒 Zadania
Zadanie 15.5.1. Narysuj (słownie) przepływ informacji dla tłumaczenia „Ala ma kota" → „Alice has a cat": co robi enkoder, co dekoder, kiedy pada <EOS>.
Pokaż rozwiązanie
Enkoder: Ala→ma→kota, stany po drodze, finalne podsumowanie. Dekoder: start od tego podsumowania (+ znacznik startu), generuje Alice, has, a, cat, … aż <EOS>. Każdy krok dekodera aktualizuje własne stany i patrzy na dotychczas wygenerowane słowa.
Zadanie 15.5.2. (podsumowujące dział) Ułóż w pięciu zdaniach drogę: LM z oknem → limit n-gramu → RNN → LSTM → seq2seq → zapowiedź transformera.
Pokaż rozwiązanie
Model językowy przewiduje następny token z krótkiego okna. Sztywne okno (n-gram) nie łapie długich zależności ani porządku. RNN niesie stan krok po kroku, ale gradient zanika. LSTM bramkami przedłuża pamięć, wciąż sekwencyjnie i drogo. seq2seq składa enkoder i dekoder do tłumaczenia całych zdań — i dziedziczy limity RNN. Transformer (2017) zostawia enkoder–dekoder, wyrzuca pętlę, daje uwagę i paralelizm.
🔍 Sprawdź, czy umiesz
- [ ] Zdefiniować seq2seq i podać zastosowania.
- [ ] Opisać enkoder, dekoder, <EOS>.
- [ ] Wskazać wady dziedziczone po RNN/LSTM.
- [ ] Powiedzieć, co adresuje Dział 16.