Uproszczony model transformatora: od tokenu do rozkładu prawdopodobieństwa
🎯 Po co Ci to?
Czas złożyć klocki: osadzenia + pozycje + uwaga w enkoderze i dekoderze na konkretnym tłumaczeniu. To mapa, którą potem tylko „powiększysz" skalą (16.5) i douczaniem (17).
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- przejść krokami tłumaczenie „Ala ma kota" → „Alice has a cat";
- wskazać dwa bloki uwagi w dekoderze;
- powiedzieć, gdzie pojawia się Softmax / następny token;
- odróżnić równoległe kodowanie wejścia od sekwencyjnego generowania wyjścia.
🔁 Przypomnij sobie
seq2seq (15.5): enkoder → podsumowanie → dekoder do <EOS>. Softmax (10.3): rozkład po słowniku. Uwaga i pozycje (16.2–16.3).
📘 Przebieg (jak w książce)
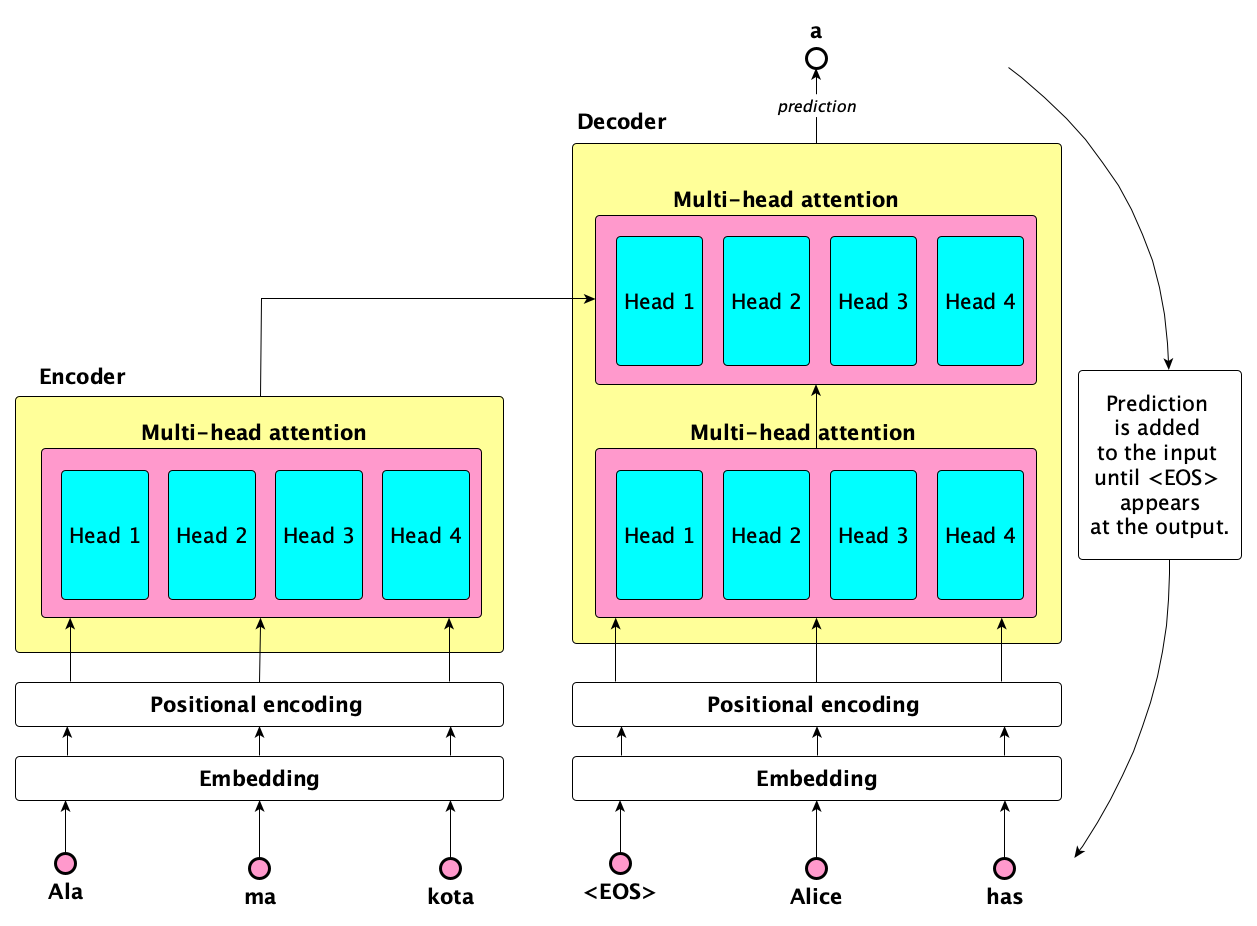
- Wejście „Ala ma kota" → wektory osadzeń. Wyjście „Alice has a cat" też ma osadzenia — ale przy generowaniu na początku znasz tylko start (znacznik początku / pierwsze słowo), nie całe zdanie docelowe naraz.
- Do osadzeń dodajesz kodowanie pozycyjne. Dla wszystkich słów wejścia osadzenia + pozycje liczą się jednocześnie.
- Enkoder: wielogłowa uwaga analizuje każde słowo wejścia w kontekście wszystkich innych → przetworzone reprezentacje zdania źródłowego.
- Dekoder generuje kolejne słowa. Ma (w uproszczeniu) dwa bloki uwagi:
- pierwszy patrzy na dotychczas wygenerowaną część wyjścia;
- drugi łączy informacje dekodera z wyjściami enkodera (kontekst zdania źródłowego).
- Po warstwach dekodera — Softmax — najbardziej prawdopodobny następny token. Powtarzasz aż do znacznika końca sekwencji.
Całość: równoczesna analiza kontekstu i kolejności, bez RNN.
📐 DEFINICJA — dekoder z uwagą do enkodera: etap, w którym generowane wyjście „zagląda" do reprezentacji całego wejścia (nie tylko do jednego wektora-podsumowania jak w klasycznym wąskim seq2seq).
💭 Pomyśl
Dlaczego dekoder przy treningu / generowaniu nie może w kroku t „patrzeć w przyszłość" na tokeny wyjścia, których jeszcze nie było?
Podpowiedź
Bo w użyciu ich jeszcze nie ma — model pisze od lewej. Przy treningu stosuje się maskowanie przyszłych pozycji, żeby nie oszukiwać. Inaczej nauczyłby się kopiować odpowiedź zamiast ją przewidywać.
⚠️ Częsty błąd
Częsty błąd: „Transformer zawsze generuje całe zdanie wyjściowe naraz, skoro jest równoległy."
Elenchus: Enkoder jest równoległy po pozycjach wejścia. Generowanie po stronie dekodera nadal idzie token po tokenie (autoregresja) — równoległość dotyczy obliczeń uwagi w warstwie, nie magicznego wypisania całego akapitu w jednej chwili bez kolejności.
🌍 Powiązania
- 15.5 — ten sam kontrakt tłumaczenia; inna wnętrzność.
- 17.1 — GPT ≈ dekoderowy transformer jako LM (przewiduj następny token).
📐 Definicje tej lekcji
- Autoregresja — kolejny token zależy od poprzednio wygenerowanych.
- Uwaga enkoder–dekoder — most z wejścia do generowania.
📌 Najważniejsze w pigułce
- Osadzenie + pozycja → uwaga enkodera.
- Dekoder: uwaga na własne wyjście + na enkoder.
- Softmax → następny token → aż EOS.
- Równoległość ≠ „cała odpowiedź w jednym strzale bez kolejności".
🎒 Zadania
Zadanie 16.4.1. Ułóż pięć punktów-checklistę przebiegu tłumaczenia w transformerze (od tokenizacji do EOS).
Pokaż rozwiązanie
(1) Tokeny → osadzenia. (2) + pozycje. (3) Enkoder / multi-head. (4) Dekoder: self-attn + attn do enkodera. (5) Softmax → token; pętla do EOS.
Zadanie 16.4.2. Porównaj jednym zdaniem wąskie gardło „jeden finalny stan" w seq2seq LSTM z mostem uwagi dekoder→enkoder.
Pokaż rozwiązanie
W LSTM-seq2seq dekoder dostaje głównie skompresowane podsumowanie; w transformerze może ważyć wszystkie pozycje enkodera przy każdym kroku generowania.
🔍 Sprawdź, czy umiesz
- [ ] Opisać przebieg na przykładzie Ali.
- [ ] Nazwać dwa bloki uwagi dekodera.
- [ ] Wskazać Softmax i EOS.
- [ ] Odróżnić paralelizm enkodera od autoregresji.