Pretrening: czytanie internetu słowo po słowie
🎯 Po co Ci to?
Z książki: zrozumienie transformera to dopiero początek ChatGPT. Najpierw powstaje surowy LLM — świetny w płynnym tekście, zawodny w robieniu tego, o co prosisz.
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- opisać pretrening jako przepuszczenie tekstu przez transformera;
- wyjaśnić, czemu odpowiedź bywa „szyciem" zamiast wykonaniem instrukcji;
- zilustrować to przykładem charakterystyki Stasia Tarkowskiego;
- sformułować problem: jak douczyć LLM, by słuchał promptów.
🔁 Przypomnij sobie
LLM (16.5/17.1) przewiduje następny token. Prompt to też tylko ciąg tokenów na wejściu.
📘 Kalkulator statystyczny
Tworzenie LM: duża ilość tekstu × architektura transformera.
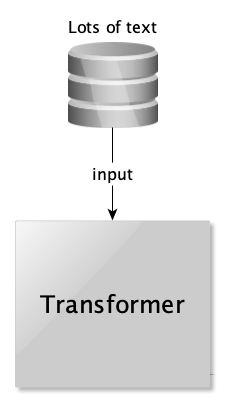
Efekt: na wejściu prompt, na wyjściu kontynuacja oparta na statystyce języka z treningu.
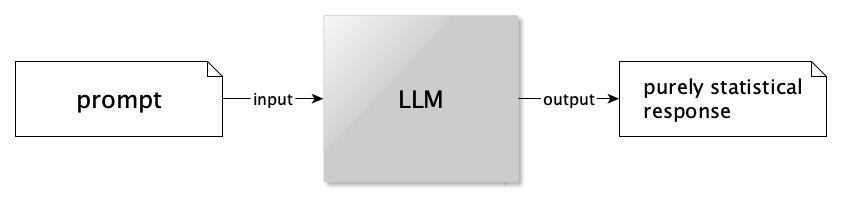
Bez dodatkowych zabiegów model nie gwarantuje realizacji oczekiwań z promptu. Może generować treści nieprawdziwe, dyskryminujące lub po prostu niepomocne — bo uczył się z danych, jakie dostał (garbage in, garbage out).
Przykład z książki. Prompt:
Napisz charakterystykę Stanisława Tarkowskiego, głównego bohatera powieści „W pustyni i w puszczy".
Surowy model (w stylu GPT-3) może potraktować to jak początek wypracowania i dokończyć plan:
- Przedstawienie postaci…
- Wygląd…
- Charakter…
— zamiast napisać charakterystykę. Jak niedouczony student, który „szyje": gramatycznie OK, merytorycznie obok pytania.
Oczekiwana odpowiedź douczonego modelu zaczyna się od treści o Stasiu, Nel, przygodzie — nie od planu.
Problem do rozwiązania: mając wyuczony LLM, douczyć (fine-tune) go tak, by wykonywał instrukcje: streszczenie → streszczenie, stolica Polski → Warszawa, tłumaczenie → tłumaczenie.
💭 Pomyśl
Dlaczego z punktu widzenia predykcji tokenu „plan wypracowania" po takim promptcie może być bardziej prawdopodobny w danych niż od razu charakterystyka?
Podpowiedź
W szkolnych / internetowych tekstach po sformułowaniu tematu często idzie plan albo „według punktów". Model kontynuuje najczęstszy wzorzec, nie „intencję użytkownika czatu".
⚠️ Częsty błąd
Częsty błąd: „Skoro model przeczytał Sienkiewicza, na pewno wykona polecenie o Stasiu."
Elenchus: Pretrening nie oznacza trybu „wykonuj rozkazy". Oznacza „dokładaj prawdopodobne tokeny".
🌍 Powiązania
- 17.3 — SFT jako pierwsza naprawa.
- 18 — limity mimo douczenia.
📐 Definicje tej lekcji
- Pretrening LM — uczenie przewidywania tokenu na ogromnym korpusie.
- Prompt — wejściowy ciąg (pytanie / instrukcja / początek tekstu).
- Fine-tuning (douczanie) — dalsze dostrajanie parametrów pod nowe dane / cel.
📌 Najważniejsze w pigułce
- Pretrening = statystyka języka, nie asystent.
- Prompt bywa kontynuowany, nie „rozumiany" jako rozkaz.
- Przykład Stasia demaskuje lukę.
- Cel: douczyć pod instrukcje użytkownika.
🎒 Zadania
Zadanie 17.2.1. Podaj własny prompt, przy którym surowy LM mógłby „szyć" (kontynuować format zamiast wykonać zadanie).
Pokaż rozwiązanie
Np. „Napisz krótki e-mail z przeprosinami do nauczyciela" → model dopisuje „Napisz krótki e-mail… według wzoru: 1. Zwrot… 2. …" zamiast treści maila.
Zadanie 17.2.2. Sformułuj jednym zdaniem problem OpenAI po GPT-3 (jak w książce).
Pokaż rozwiązanie
Jak douczyć wielki LM, żeby realizował oczekiwania z promptów (instrukcje), a nie tylko generował prawdopodobną kontynuację tekstu.
🔍 Sprawdź, czy umiesz
- [ ] Opisać pretrening.
- [ ] Wyjaśnić lukę prompt vs instrukcja.
- [ ] Przywołać przykład Stasia.
- [ ] Nazwać cel fine-tuningu.