Człowiek doucza maszynę: instrukcje i przykłady (SFT)
🎯 Po co Ci to?
Pierwsze podejście OpenAI (w opisie z książki): zatrudnić ludzi jak korepetytorów dla „studenta, który oblał egzamin" — niech napiszą, jak powinna wyglądać dobra odpowiedź.
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- opisać rolę ~40 korepetytorów i ~13 tys. par pytanie–odpowiedź;
- wyjaśnić SFT (supervised fine-tuning);
- powiedzieć, skąd wzięto prompty (rzeczywiste użycie GPT-3);
- opisać drugi ruch: zamiast pisać — rankinguować odpowiedzi SFT i budować dane do modelu nagród.
🔁 Przypomnij sobie
17.2: surowy LLM. Uczenie nadzorowane: przykłady wejście→wyjście, minimalizacja różnicy.
📘 40 korepetytorów i SFT
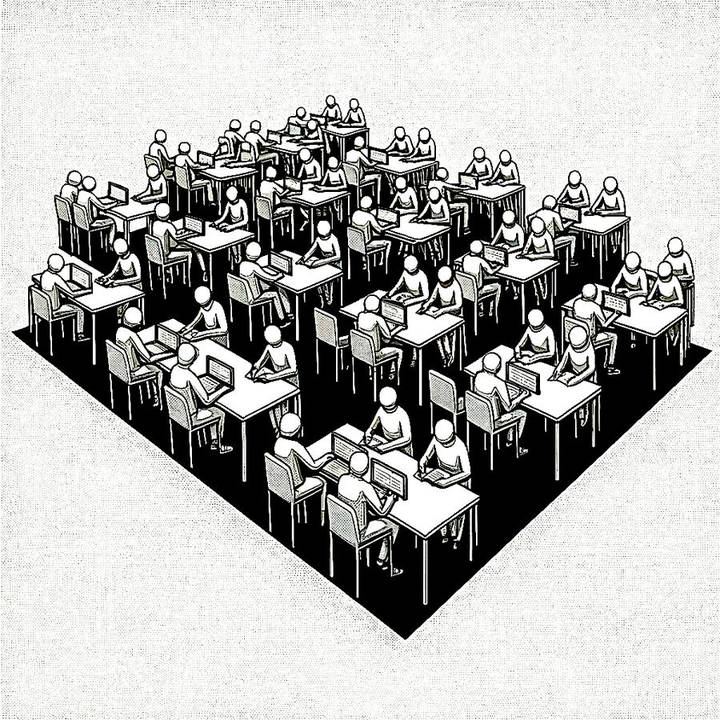
OpenAI zatrudniło ok. 40 korepetytorów. Pytania: m.in. rzeczywiste prompty użytkowników GPT-3 (sprytne: widać, czego ludzie chcą). Odpowiedzi: prawdziwe względem oczekiwań, starannie pod kątem etyki / braku dyskryminacji. Zebrano ok. 13 tys. par pytanie–odpowiedź (opowiadania, Q&A, dialogi, streszczenia…).
Douczanie: start nie od „czystej tablicy" — model już generuje tekst. Dostrajamy wagi, by odpowiedzi były bliżej wzorców korepetytorów.
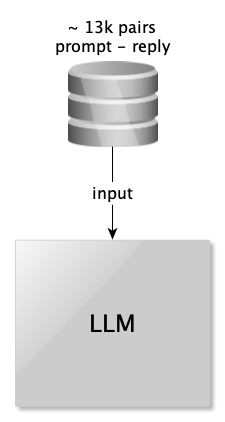
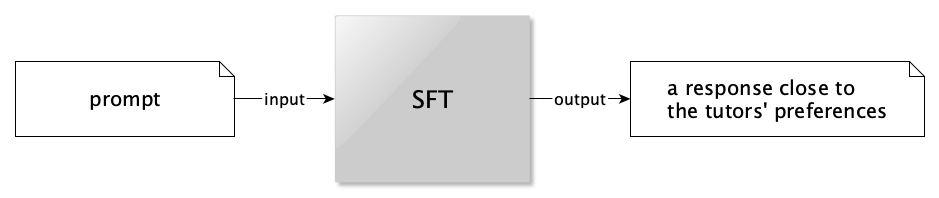
📐 DEFINICJA — SFT (supervised fine-tuning): nadzorowane douczanie LM na parach (prompt, wzorcowa odpowiedź), tak by generować odpowiedzi zgodne z przykładami (preferencjami korepetytorów / użytkowników).
SFT jest lepszy od surowego LM — i wciąż za słaby / za drogi do skalowania samym pisaniem. Pisanie 13k odpowiedzi jest kosztowne i nudne. Pomysł: niech SFT generuje kilka odpowiedzi na prompt, a ludzie tylko uporządkują je od najlepszej do najgorszej.
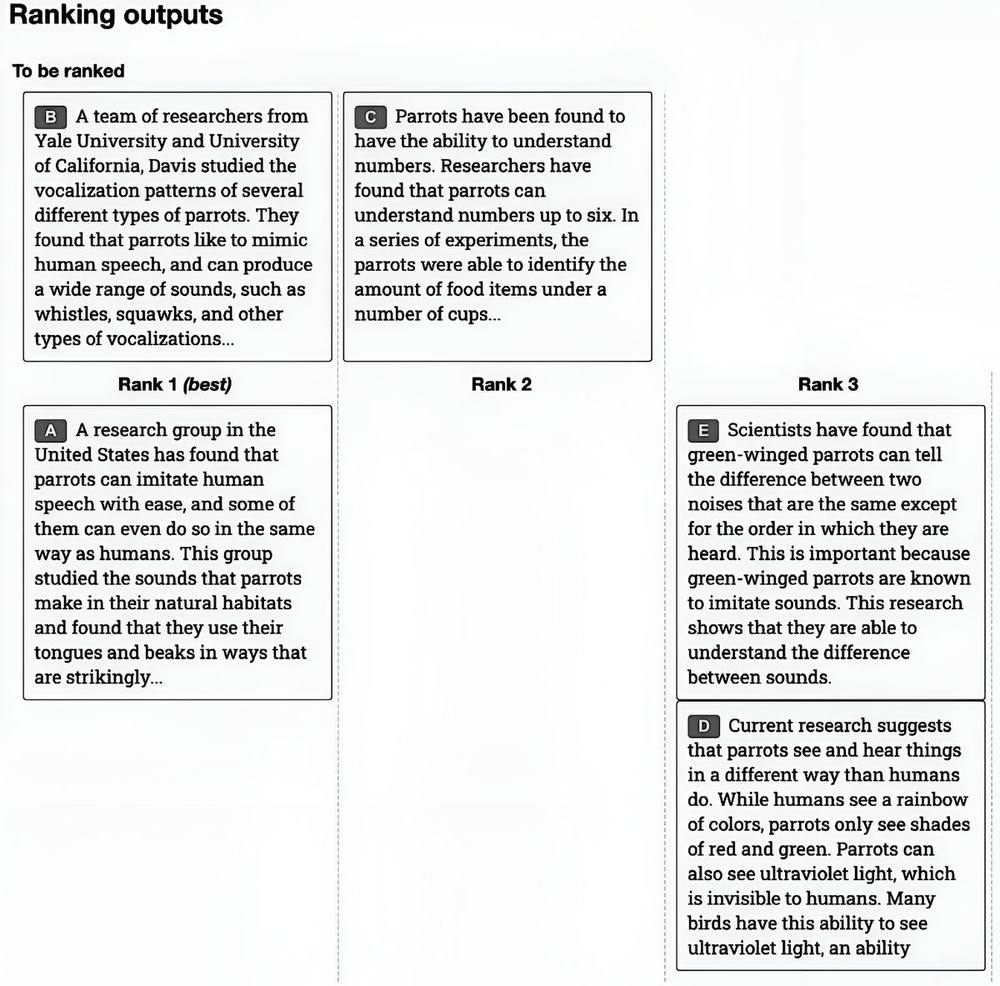
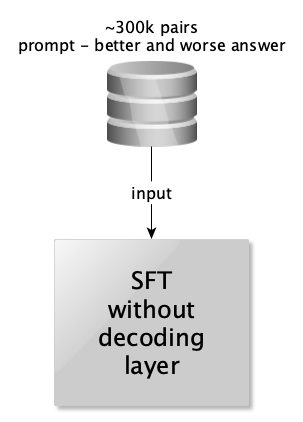
Nowa pula promptów (rzędu 30–50 tys.). SFT generuje 4–9 odpowiedzi na prompt. Korepetytorzy sortują. Z rankingu powstają pary (lepsza, gorsza). Z jednego promptu — wiele przykładów (w książce: z rankingu A≻B≻C≻D≻E pary w stylu (A,C), (A,D), …). Skala zbioru: rzędu ~300 tys. rekordów (prompt, lepsza, gorsza).
📘 Model nagród (RM) — zapowiedź
Na tych trójkach uczy się model nagród (reward model, RM): klon SFT bez warstwy dekodującej tekst. Nie pisze — dla pary (prompt, odpowiedź) zwraca liczbę = ocenę jakości (nagrodę).
Cel: dla promptu P, lepszej L i gorszej G mieć (r(P,L) > r(P,G)). Funkcja straty karze, gdy gorsza dostaje wyższą ocenę niż lepsza.
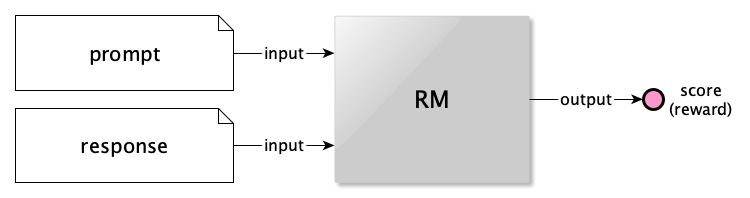
📐 DEFINICJA — model nagród (RM): model mapujący (prompt, odpowiedź) → liczba (ocena / nagroda), uczony na ludzkich porównaniach lepsza/gorsza.
💭 Pomyśl
Dlaczego ocenianie gotowych odpowiedzi jest tańsze niż pisanie ich od zera — i co zyskujemy poza ceną?
Podpowiedź
Szybciej; ludzie porównują względnie („A lepsze niż B") łatwiej niż piszą ideał; z jednego promptu wiele par treningowych.
⚠️ Częsty błąd
Częsty błąd: „SFT wystarczy — RLHF to marketing."
Elenchus: Książka i InstructGPT: SFT pomaga, ale ranking + RM + RL otwierają skalę preferencji bez pisania miliona wzorców ręcznie. ChatGPT w tej narracji powstaje dopiero po RLHF.
🌍 Powiązania
- 9.x — uczenie nadzorowane vs ze wzmocnieniem (RL w 17.4).
- 17.4 — użycie SFT+RM w pętli RLHF.
📐 Definicje tej lekcji
- SFT — douczanie na wzorcowych odpowiedziach.
- Ranking odpowiedzi — porządek → pary lepsza/gorsza.
- RM — skorer preferencji człowieka.
📌 Najważniejsze w pigułce
- Ludzie piszą ~13k wzorców → SFT.
- Potem ludzie rankingują wyjścia SFT → dane do RM.
- RM: (prompt, odpowiedź) → liczba.
- To półmetek drogi do ChatGPT.
🎒 Zadania
Zadanie 17.3.1. Czym różni się dane treningowe SFT od danych do RM?
Pokaż rozwiązanie
SFT: pary (prompt, jedna wzorcowa odpowiedź). RM: (prompt, lepsza, gorsza) z ludzkiego rankingu — uczy porównywać, nie pisać.
Zadanie 17.3.2. Po co usuwać warstwę dekodującą w RM?
Pokaż rozwiązanie
RM nie ma generować tekstu dla użytkownika — ma zwracać ocenę. Dekoder (unembedding do słownika) jest zbędny; wyjściem jest skalar.
🔍 Sprawdź, czy umiesz
- [ ] Opisać SFT i rolę korepetytorów.
- [ ] Wyjaśnić przejście do rankingu.
- [ ] Zdefiniować RM.
- [ ] Podać rzędy wielkości (~13k, ~300k).