RLHF: maszyna doucza się z ludzkich ocen
🎯 Po co Ci to?
Mamy SFT i RM. Brakuje trzeciego aktu: uczenie ze wzmocnieniem, w którym polityka (kopia SFT) maksymalizuje nagrody z RM — z hamulcem, by nie „oszukać" skorer i nie zejść na bełkot.
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- wyjaśnić ideę RL (stan, działanie, polityka, nagroda) na poziomie książki;
- zmapować to na LM: prompt / następny token / wagi modelu / RM;
- opisać pętlę RLHF z karą za odejście od SFT;
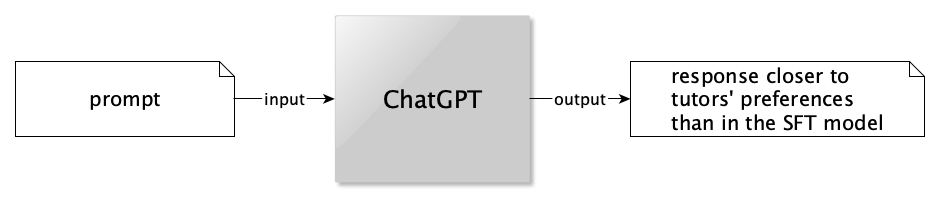
- powiedzieć, że wynik tej pętli to model w stylu ChatGPT.
🔁 Przypomnij sobie
AlphaGo (13.3) — też RL. SFT i RM (17.3).
📘 Uczenie ze wzmocnieniem (skrót)
Dotąd w podręczniku dominowało uczenie z danych (korelacje w zbiorze). RL (reinforcement learning): agent w środowisku, stan → działanie → nagroda → nowy stan. Uczy się polityki (odwzorowanie stan→działanie), by zbierać jak najwięcej nagród (metafora smakołyków przy tresurze).
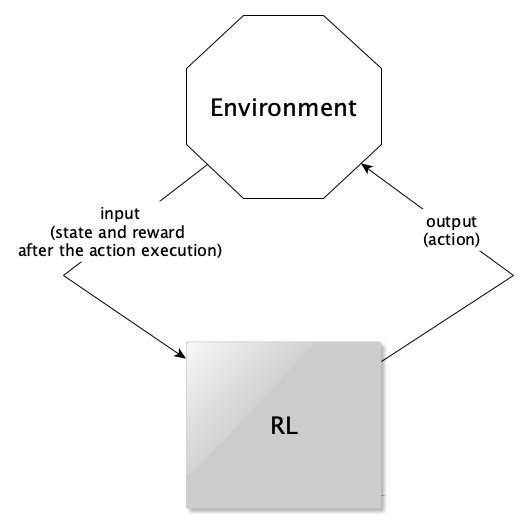
Przykłady: AlphaGo, (częściowo) jazda autonomiczna.
📘 RLHF na modelu językowym
RLHF = Reinforcement Learning from Human Feedback.
| Element RL | W LM |
|---|---|
| Stan | prompt (ciąg tokenów) |
| Działanie | generowanie kolejnego tokenu / odpowiedzi |
| Polityka | parametry modelu (tu: kopia SFT dostrajana w RL) |
| Nagroda | ocena z RM (preferencje ludzi / korepetytorów) |
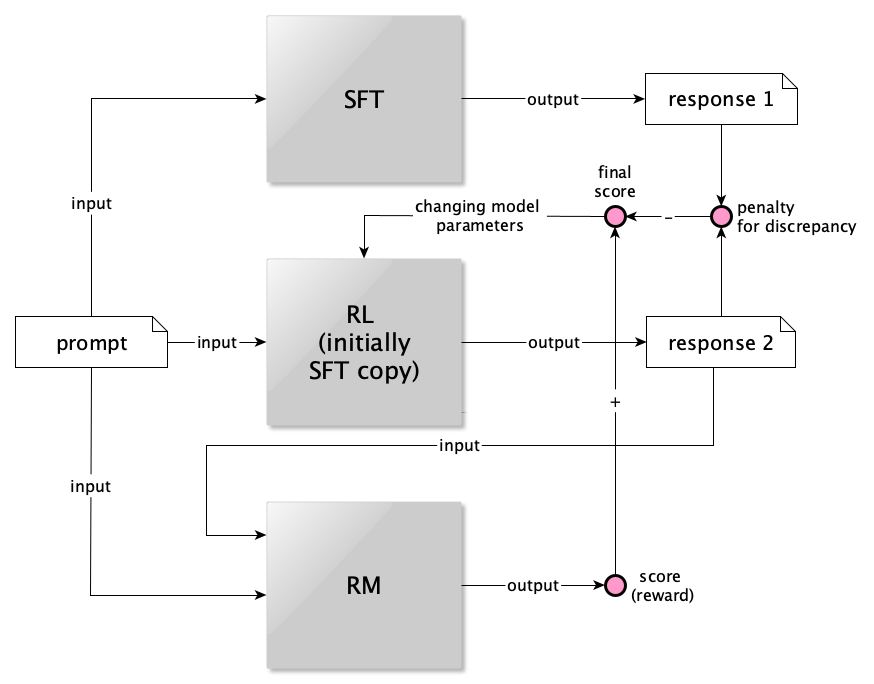
Przebieg (jak w książce):
- Kopia SFT → model RL (polityka).
- Nowa kolekcja promptów (~30 tys.).
- Ten sam prompt → odpowiedź₁ z SFT i odpowiedź₂ z RL.
- RM ocenia odpowiedź₂ → nagroda.
- Liczymy rozbieżność odpowiedzi₂ względem odpowiedzi₁ — kara, jeśli RL odejdzie za daleko od SFT (inaczej RL mógłby generować dziwaczny tekst, który oszukuje RM wysoką oceną).
- Nagroda końcowa = ocena RM − kara; aktualizujemy politykę RL, by maksymalizować nagrody.
- Po treningu: model RL ≈ ChatGPT (w uproszczeniu książki).
📐 DEFINICJA — RLHF: dostrajanie modelu językowego uczeniem ze wzmocnieniem, gdzie sygnał nagrody pochodzi z modelu nagród nauczonego na ludzkich preferencjach (rankingach).
📐 DEFINICJA — polityka (w RLHF): parametry LM decydujące, jakie tokeny generować; obiekt optymalizacji.
💭 Pomyśl
Po co kara za odejście od SFT, skoro RM już „wie", co ludzie lubią?
Podpowiedź
RM jest niedoskonały. Bez kotwicy do SFT polityka może znaleźć luki skoreru (wysoka „nagroda", bezużyteczny tekst). Kara trzyma język w okolicy sensownych odpowiedzi SFT.
⚠️ Częsty błąd
Częsty błąd: „RLHF uczy model prawdy o świecie."
Elenchus: Uczy preferowanych stylów odpowiedzi według korepetytorów / procedur OpenAI — nie omniscjencji. Nadal może halucynować.
🌍 Powiązania
- 13.3 — RL w grach.
- 17.5 — skutek społeczny premiery.
- 18–20 — limity i ryzyka.
📐 Definicje tej lekcji
- RL — uczenie z nagród w środowisku.
- RLHF — RL z nagrodą z ludzkiego feedbacku (przez RM).
- Kara względem SFT — regularizacja polityki.
📌 Najważniejsze w pigułce
- RL: maksymalizuj sumę nagród.
- W czacie: prompt / tokeny / wagi / RM.
- Hamulec: nie odchodź za daleko od SFT.
- Wynik pętli = model typu ChatGPT.
🎒 Zadania
Zadanie 17.4.1. Uzupełnij: stan = …, działanie = …, nagroda = ….
Pokaż rozwiązanie
Stan = prompt; działanie = generowanie odpowiedzi/tokenów; nagroda = ocena RM (minus kara vs SFT).
Zadanie 17.4.2. Wyjaśnij ryzyko reward hacking jednym zdaniem.
Pokaż rozwiązanie
Polityka może znaleźć odpowiedzi, które RM ocenia wysoko, choć dla człowieka są złe lub bezsensowne — stąd kotwica do SFT.
🔍 Sprawdź, czy umiesz
- [ ] Opisać RL skrótowo.
- [ ] Zmapować RLHF na LM.
- [ ] Wyjaśnić rolę kary vs SFT.
- [ ] Połączyć wynik z ChatGPT.