Co mówią badania: co działa, a co szkodzi
🎯 Po co Ci to?
Debata „zakazać AI / pozwolić na wszystko" jest za biedna. Badania nie dają magicznej odpowiedzi, ale pokazują wzorce: kiedy AI pomaga uczeniu się, a kiedy je podkopuje — i że liczy się projekt narzędzia, nie sama marka modelu.
✅ Czego się nauczysz
Po tej lekcji potrafisz:
- streścić problem dwóch sigm Blooma i powiedzieć, co z niego wynika dla AI;
- zestawić wynik Bastaniego (ogólny GPT) z wynikiem Kestina (AI-tutor pod aktywne uczenie);
- powtórzyć syntezę OECD: partner, nie skrót; hybrydy > ogólne chatboty; nauczyciel nie znika.
🔁 Przypomnij sobie
Z 21.1: performance ≠ learning. Z Działu 3: „inteligentny program" automatyzuje proces myślowy — ale w edukacji automatyzacja za ucznia bywa wrogiem nauki.
📘 Wyjaśnienie
Bloom: tutoring 1:1 działa — tylko jest drogi
W 1984 roku Benjamin Bloom opisał problem dwóch sigm: uczniowie z indywidualnym tutoringiem osiągali wyniki o dwa odchylenia standardowe powyżej przeciętnej klasy. W praktyce: przeciętny uczeń z dobrym tutorem lądował wśród najlepszych kilku procent. Problem Blooma: takiego tutoringu nie dało się dać każdemu — za drogo, za mało nauczycieli.
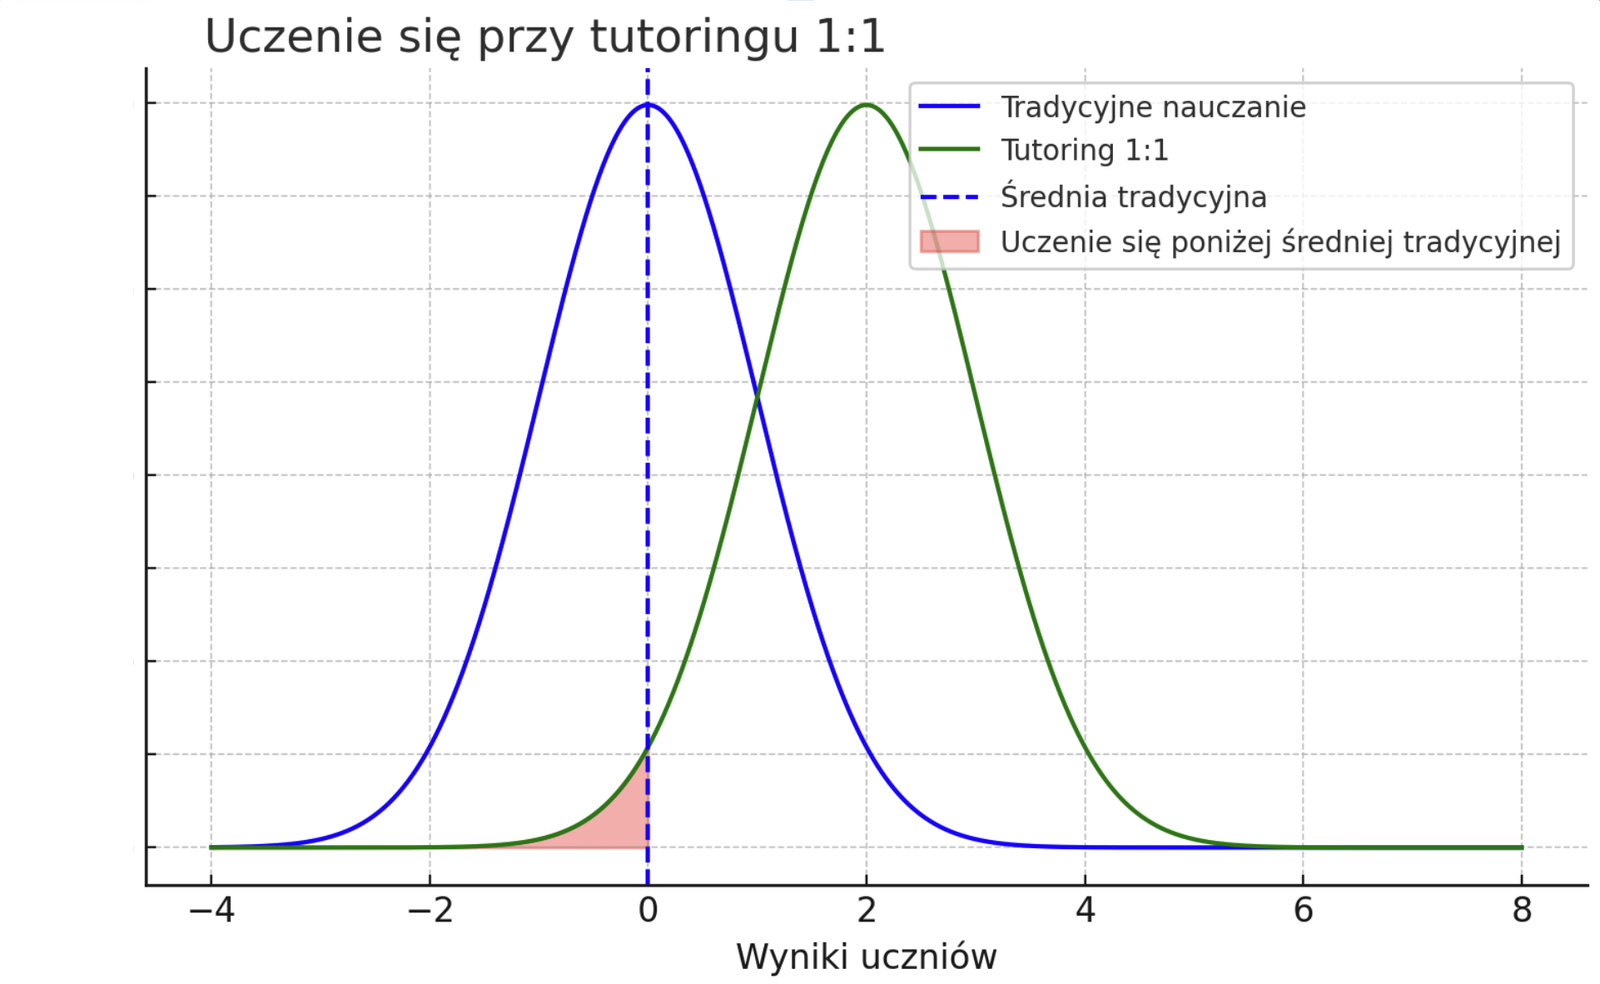
📐 DEFINICJA — problem dwóch sigm (Bloom): empiryczna przewaga tutoringu 1:1 nad klasą (~2 odchylenia standardowe) przy jednoczesnej niemożności skalowania tego modelu tradycyjnymi środkami.
AI obiecuje skalę: indywidualna rozmowa dla wielu uczniów naraz. Ale — jak pokazał 21.1 — zła skala (gotowe odpowiedzi) może pogorszyć wyniki. Pytanie badawcze brzmi więc: jak zaprojektować AI-tutora, żeby przybliżał się do Blooma, a nie do Bastaniego.
Dwa eksperymenty, dwa wnioski
Ogólny chatbot (skrót). Bastani i in. (2024), liceum, matematyka, Turcja: ćwiczenia z GenAI wyglądały świetnie; egzamin bez pomocy — grupa z ogólnym GPT słabiej niż samodzielni (~17%). Mechanizm: mniej własnego wysiłku metakognitywnego („metacognitive laziness").
Zaprojektowany tutor (partner). Kestin i in. (2025), fizyka, Harvard: AI-tutor skonfigurowany pod aktywne uczenie się (pytania, naprowadzanie, nie wykład za studenta) dał efekt rzędu ~0,6 odchylenia standardowego względem aktywnej nauki na sali — przy wyższej motywacji i zaangażowaniu. Effect size (~0,6 SD) to w pedagogice duży, praktycznie ważny efekt — nie „statystyczny szum".
Morał wspólny z OECD, meta-analiz i wdrożeń (m.in. LearnLM/Eedi, Khanmigo): projekt pedagogiczny > sam model. Ten sam LLM może szkodzić albo pomagać — zależnie od reguł rozmowy.
💭 Pomyśl: Gdybyś projektował regułę dla szkolnego AI na jedną noc: „wolno podać pełne rozwiązanie dopiero po N nieudanych próbach ucznia" — jakie N wybrałbyś i dlaczego?
Sprawdź odpowiedź
Nie ma jednej magicznej liczby. Za małe N (np. 0) = skrót. Za duże bez żadnej pomocy = frustracja. Sensowny zakres w tutoringu to często 1–3 próby z rosnącym naprowadzeniem (scaffolding), a pełne rozwiązanie — rzadko albo wcale (zamiast tego: wskazówka, analogia, pytanie diagnostyczne). W Asystencie Lekcyjnym domyślnie nie dostajesz klucza na tacy — i to jest świadomy wybór, nie „uparty bot".
Synteza OECD 2026 (w czterech punktach)
- Partner, nie skrót — cel polityki i praktyki.
- Hybrydy > ogólne chatboty — narzędzie z jawnym modelem pedagogicznym (strategie tutoringu, kotwica w programie) bije „ChatGPT z półki".
- Ewaluacja jako warunek — „edukacyjny" trzeba mierzyć wynikami uczenia się, nie marketingiem.
- Nauczyciel nie znika — najlepszy model to augmentacja: człowiek i AI w tandemie; motywacja i relacja zostają zadaniem człowieka.
⚠️ Uwaga, pułapka
Łatwo wyciągnąć z Blooma wniosek: „więc dajmy każdemu ChatGPT i mamy 2 sigmy". To nie wynika z danych. Bloom mierzył ludzki tutoring z dobrą metodyką. AI dostaje skalę dopiero wtedy, gdy metodyka jest wbudowana — inaczej dostajesz Bastaniego, nie Blooma.
📐 Definicje tej lekcji
- Problem dwóch sigm (Bloom) — przewaga tutoringu 1:1 i problem skalowania.
- Effect size (intuicyjnie) — „o ile typowo lepiej" w jednostkach rozrzutu wyników; ~0,6 SD to wyraźny, praktyczny efekt.
- Hybryda pedagogiczna — GenAI + jawne reguły tutoringu / materiał / ewaluacja, nie goły chat.
📌 Najważniejsze w pigułce
- Bloom: 1:1 działa; pytanie = jak dać to wielu.
- Ogólny GPT bywa gorszy dla uczenia się na egzaminie bez pomocy.
- Dobrze zaprojektowany AI-tutor bywa lepszy niż sama aktywna lekcja (Kestin).
- OECD: partner ≠ skrót; hybrydy; mierz; nauczyciel zostaje.
🎒 Zadania
Zadanie 21.2.1. Ułóż tabelę 2×2: wiersze „ogólny chatbot" / „AI-tutor z regułami"; kolumny „przy ćwiczeniach" / „na egzaminie bez pomocy". Wpisz jakościowo, czego spodziewasz się po Bastanim vs Kestinie.
Pokaż rozwiązanie
Ogólny chatbot: ćwiczenia — wysoki performance; egzamin — ryzyko spadku (Bastani). AI-tutor z regułami: ćwiczenia — wysoki engagement i nauka; egzamin — szansa na zysk (Kestin), bo wysiłek nie został wycięty. To uproszczenie — ale trzyma kierunek dowodów.
Zadanie 21.2.2. „Skoro AI jest tańsze niż korepetytor, szkoła powinna zastąpić korepetycje chatbotem." Napisz argument za i przeciw, odwołując się do Blooma i OECD.
Sprawdź odpowiedź
Za: skala dostępu (Bloom — problem kosztu). Przeciw: bez projektu pedagogicznego chatbot ≠ tutoring; OECD — nauczyciel i relacja zostają; ryzyko nierówności, jeśli bogatsi i tak mają ludzi, a biedniejsi — tylko skrót.
Zadanie 21.2.3. Jednym zdaniem: co z syntezy OECD zapamiętasz na najbliższy rok szkolny?
Sprawdź odpowiedź
Przykład: „Będę używał AI jako partnera (pytania, weryfikacja), nie jako skrótu do oddania pracy." Albo: „Nie uwierzę marketingowi «edukacyjny» bez reguł i dowodów."
🔍 Sprawdź, czy umiesz
- [ ] Opisać problem dwóch sigm.
- [ ] Zestawić Bastaniego z Kestinem.
- [ ] Powtórzyć cztery punkty OECD.
- [ ] Wyjaśnić, czemu „ChatGPT dla wszystkich" ≠ Bloom.